ReLU激活
|
### ReLU 激活函数知识点(错题复习)
**ReLU(Rectified Linear Unit)**:`f(x) = max(0, x)`
**核心特性**:
- x > 0 时导数恒为 1 → **缓解梯度消失**(这是相对 sigmoid/tanh 的最大优势)
- x ≤ 0 时导数为 0 → **神经元死亡**(Dead ReLU 问题)
- 计算极简(只需 max),训练快
- 稀疏激活(约 50% 神经元输出为 0)
**常见易错点(错题聚焦)**:
1. **ReLU 不是处处可导**(x=0 处不可导),但在实践中用次梯度处理不影响
2. **ReLU 输出非零中心化**(输出 ≥ 0),有类似 sigmoid 的"恒正"问题,但有偏置可缓解
3. **ReLU 缓解梯度消失 ≠ 完全没有梯度问题**:负区梯度为 0,仍可能死亡
4. **Leaky ReLU / PReLU** 是 ReLU 的改进,负区给小斜率(如 0.01x)解决死亡问题
**对比记忆**:
| 函数 | 梯度消失 | 神经元死亡 | 零中心 |
|------|---------|-----------|--------|
| Sigmoid | 严重(导数≤0.25) | 否 | 否 |
| Tanh | 中等(导数≤1) | 否 | **是** |
| **ReLU** | **轻微**(正区1) | **是** | 否 |
| Leaky ReLU | 轻微 | 否 | 否 |
|
|
### 错题:ReLU 相关
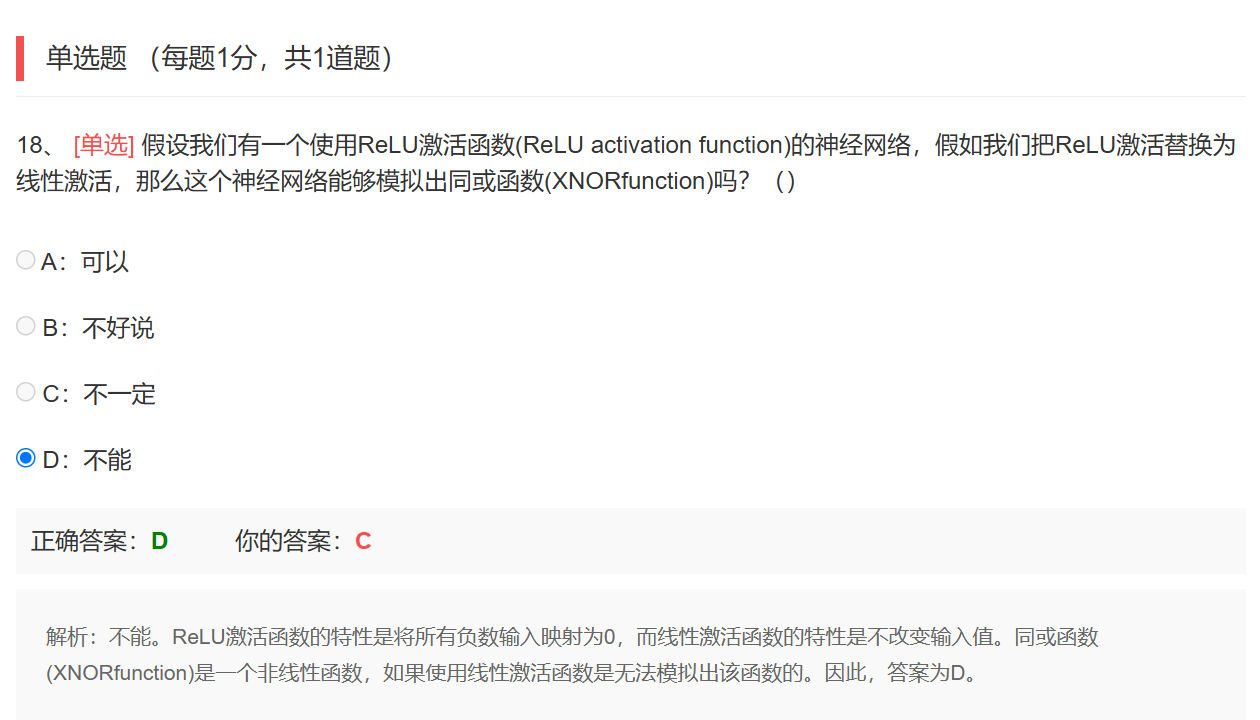
**错题反思**:本题考查 ReLU 的性质。常见错误是混淆"ReLU 解决梯度消失"与"ReLU 没有任何梯度问题"。实际 ReLU 在负输入区梯度为 0,仍存在神经元死亡风险。
**正确认知**:ReLU 主要优势是**正区导数为 1**,缓解了深层网络的梯度连乘衰减;但负区导数为 0 是其代价。Leaky ReLU 是改进方案。
|
ML策略与指标
|
### ML 策略与指标知识点(错题复习)
**Andrew Ng 的 ML 策略核心**:先建立**正确的单一评估指标**,再谈改进。
**易错点总结**:
1. **准确率在不平衡数据下误导**:99% 准确率可能漏掉所有正样本(如鸟攻击仅 0.1%)
2. **业务场景决定指标**:
- 医疗/安防 → 重**召回率**(怕漏报/假阴性)
- 垃圾邮件 → 重**精确率**(怕误杀/假阳性)
3. **指标必须单一可优化**:多目标冲突时,用满意指标 + 优化指标分离
4. **dev/test 必须匹配目标分布**:训练集可来自不同分布
5. **异常高精度先查 dev 集大小**:小 dev 集 → 模型记住样本 → 虚高
**神经风格转换(Neural Style Transfer)**:
- 用内容图 C + 风格图 S → 生成图 G
- 损失 = 内容损失(与 C 的特征差异)+ 风格损失(与 S 的 Gram 矩阵差异)
- 不需训练数据,逐图优化
**"趋势"概念混淆**:趋势 = 数据**总体统一方向**(非单调,可变向);区别于噪声、季节性、周期。
|
|
### 错题:趋势
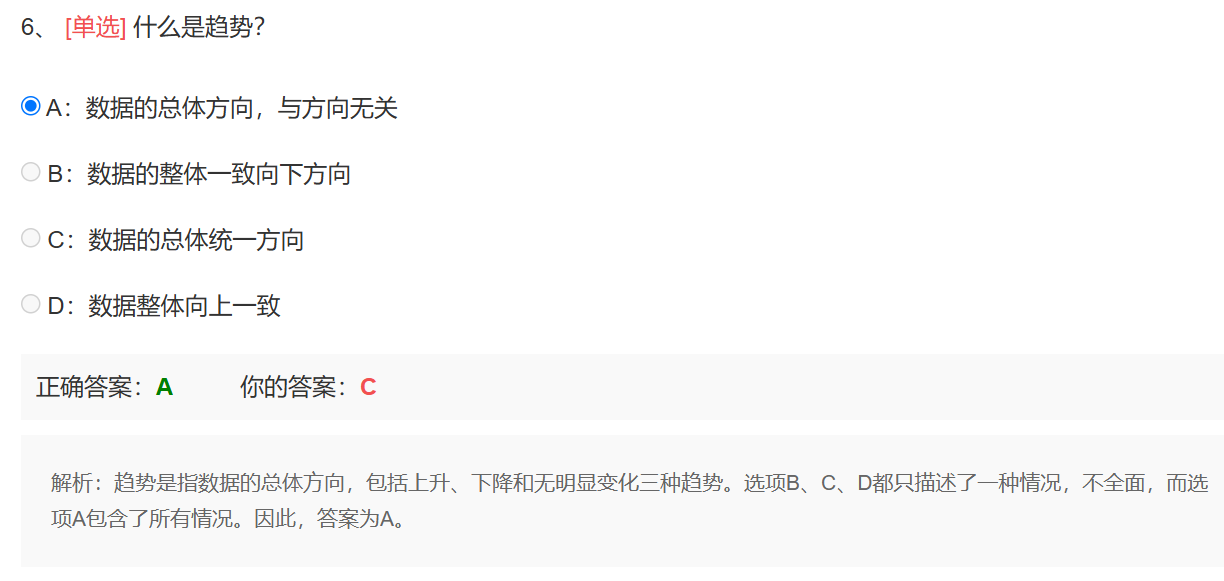
**错题反思**:时序中"趋势"易与"周期""季节性"混淆。趋势是**长期总体方向**,不要求单调。
**关键**:趋势 = 总体统一方向(上升/下降/平稳)。
|
|
### 错题:神经风格转换
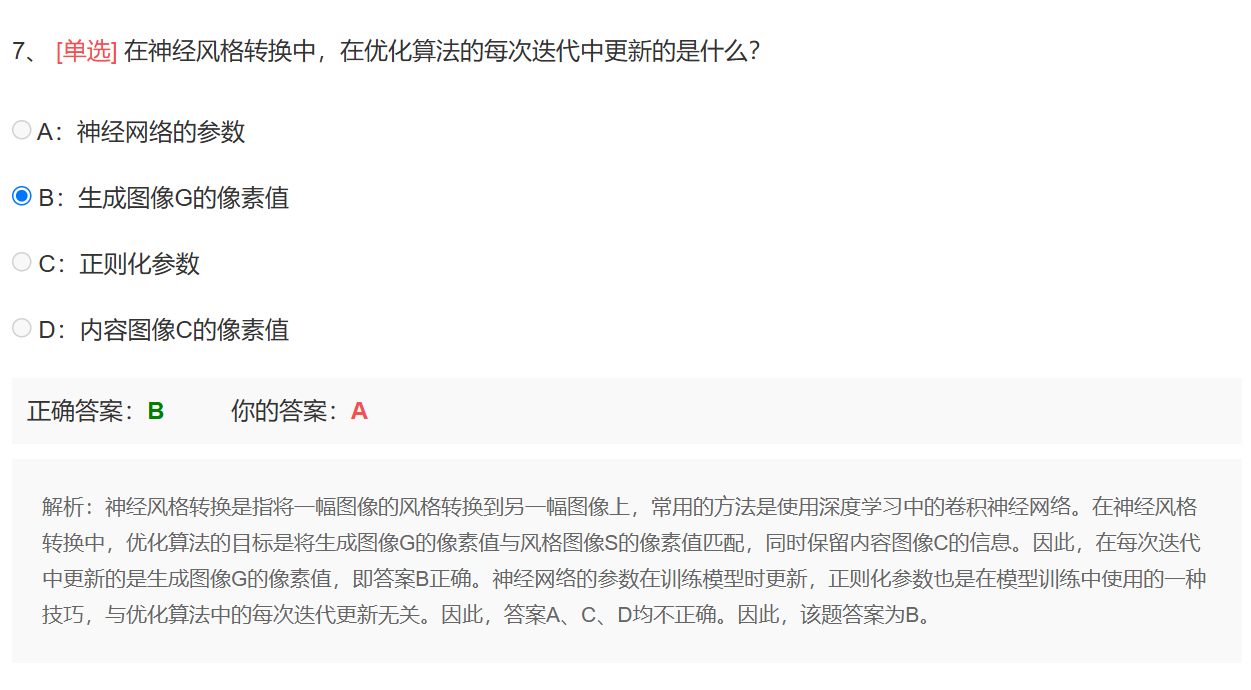
**错题反思**:神经风格转换是**逐图优化**任务(不需训练集),通过最小化内容损失 + 风格损失生成图片。
**易错**:误以为需要训练数据集,实际是测试时优化单个生成图。
|
|
### 错题:重新定义评估指标
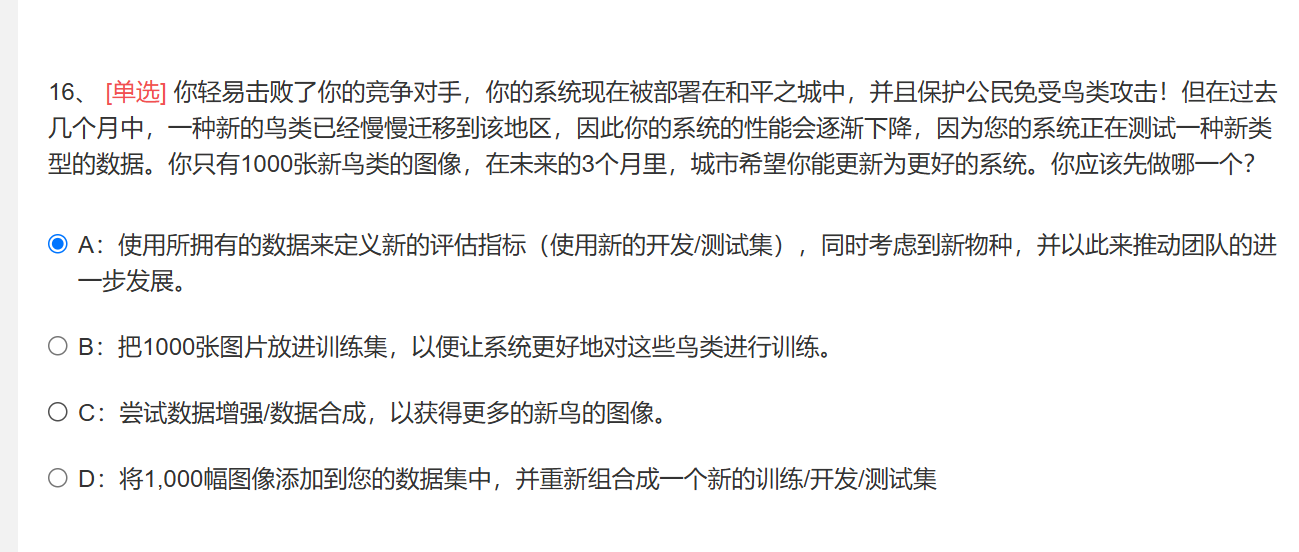
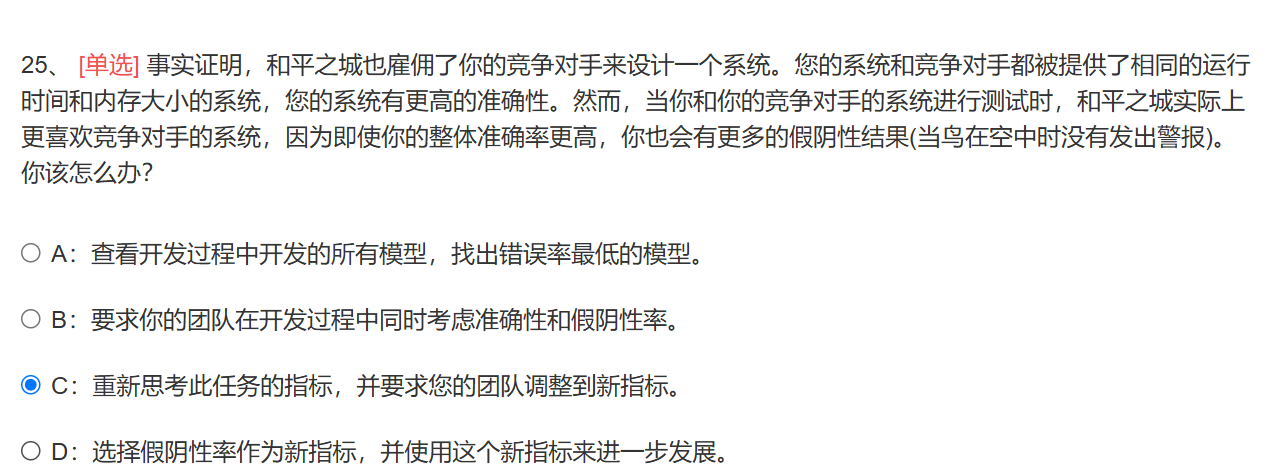
**错题反思**:当业务需求改变(如新物种出现、客户更关心假阴性),**第一步**是重新定义评估指标,而非直接改模型或加数据。
**核心原则**:先有正确指标,再谈优化方向。
|
|
### 错题:修饰语 / 迁移学习
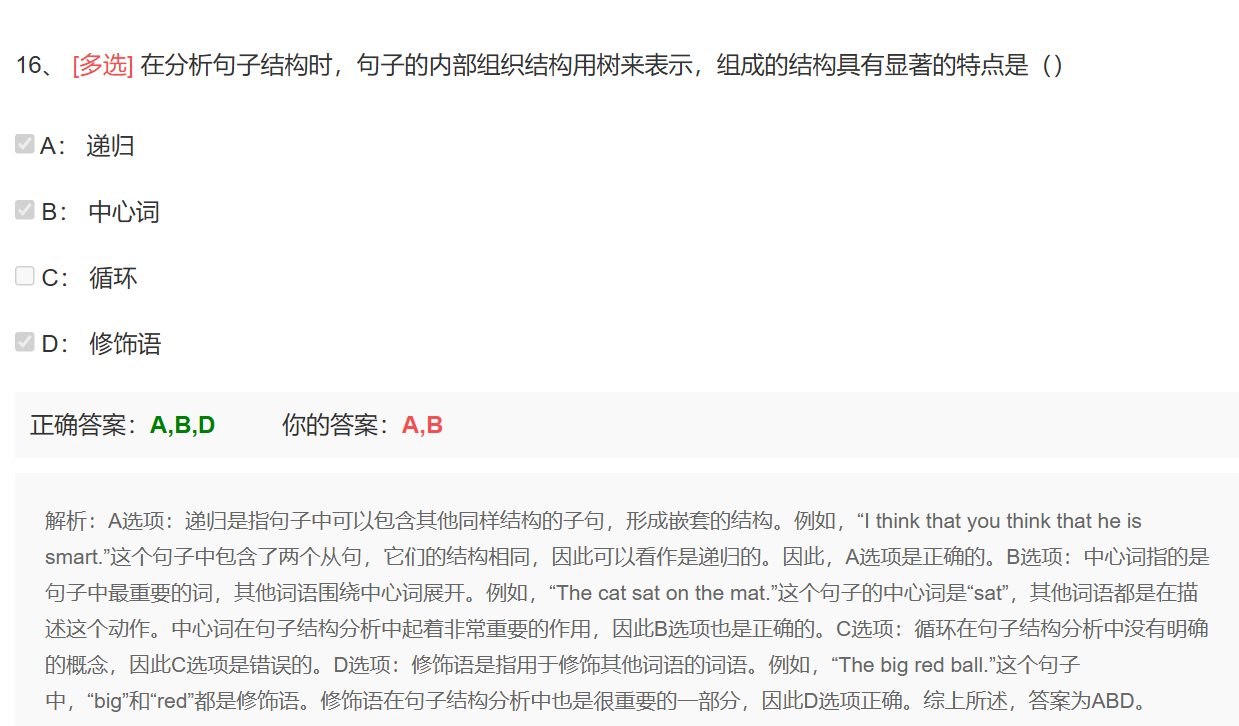
**错题反思**:本题涉及迁移学习/术语修饰语。迁移学习核心:预训练(大数据)→ 微调(小数据任务),前面层学通用特征可复用。
**易错**:混淆"迁移学习"与"多任务学习"——前者有先后(预训练→微调),后者同时学。
|
训练与梯度
|
### 训练与梯度知识点(错题复习)
**梯度消失/爆炸**:深层网络梯度经多层连乘。
- sigmoid 导数 ≤ 0.25 → 连乘急速衰减(消失)
- **ReLU 正区导数 = 1** → 不衰减(缓解)
- 其他缓解:BatchNorm、残差连接(ResNet)、LSTM 门控、Xavier/He 初始化、预训练
**参数共享(CNN)**:同一卷积核全图共享。
- 好处:减参防过拟合、特征检测器可出现在任意位置、支持迁移学习
- **不等于**稀疏表示(稀疏来自 ReLU/L1)
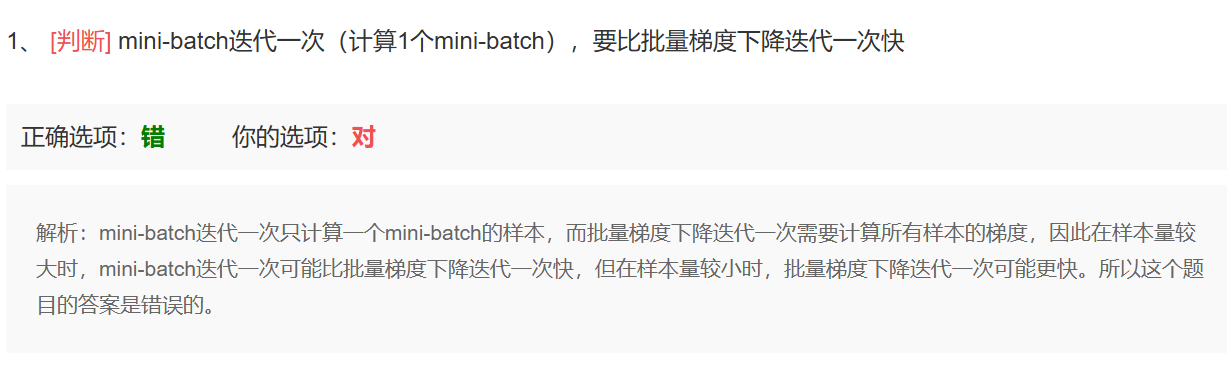
**mini-batch 大小**:batch=1 失去向量化;batch=m 每轮才更新一次。折中取 2 的幂(64/128/256)。
**tanh vs sigmoid**:tanh 输出 (-1,1) **零中心化**,梯度方向自由,收敛快于 sigmoid(输出 (0,1) 恒正,zigzag 震荡)。
**硬件加速**:GPU/TPU 是 DL 兴起三要素之一(数据+算力+算法),使深层网络可训练。
|
|
### 错题:加速芯片
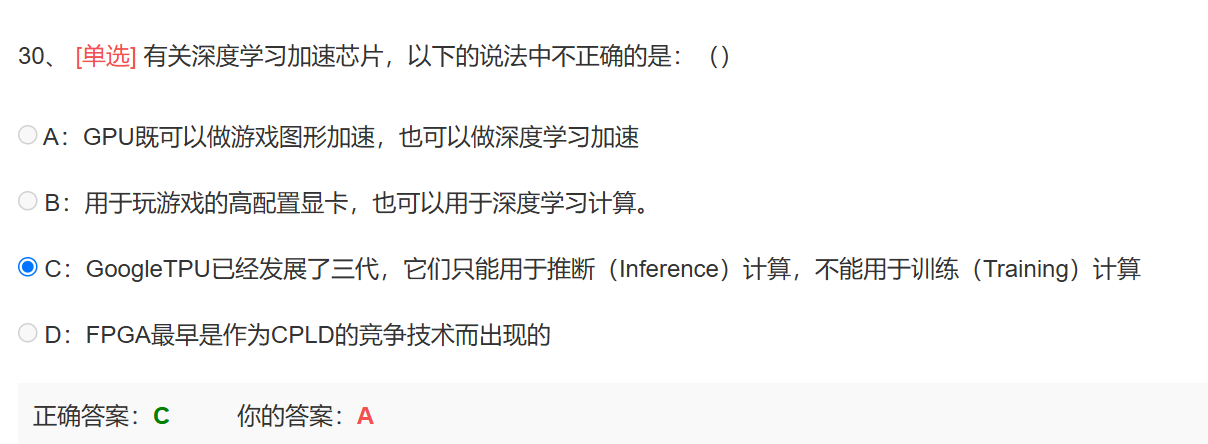
**错题反思**:本题考查 GPU/TPU 等加速硬件的作用。算力是 DL 兴起的关键,使训练深层网络(之前算不动)成为可能。
**易错**:误以为算法是唯一因素。实际是数据+算力+算法三者共同推动。
|
|
### 错题:共享参数
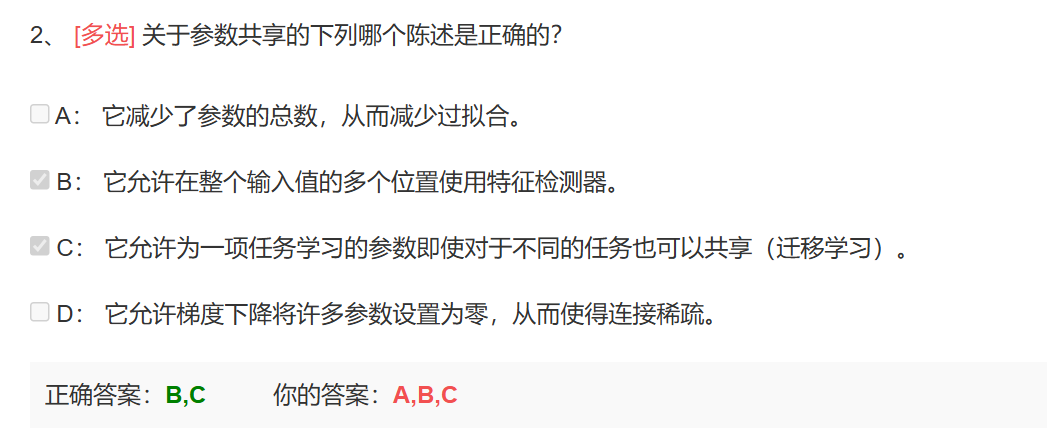
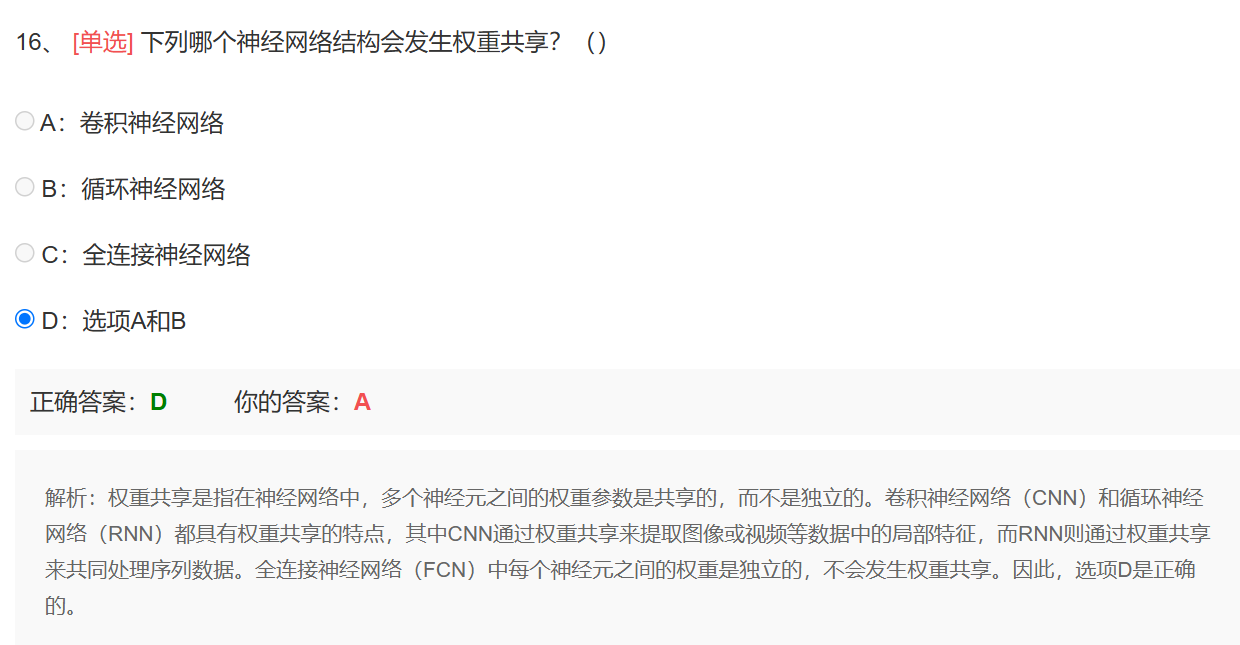
**错题反思**:参数共享的好处包括减参、多位置特征检测、迁移学习支持。**不**包括"产生稀疏表示"——稀疏来自 ReLU 或 L1 正则,与参数共享无关。
**易错**:把"参数共享"与"稀疏激活"混为一谈。
|
|
### 错题:梯度消失
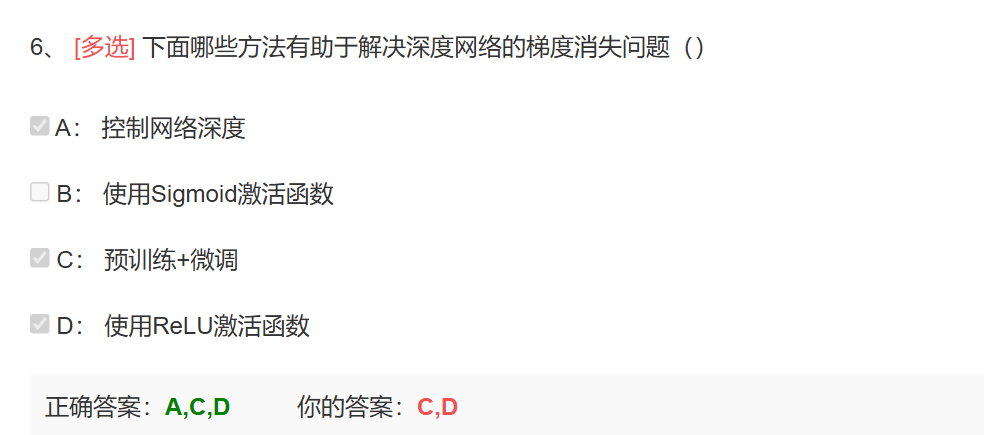
**错题反思**:缓解梯度消失的有效方法——ReLU 激活、预训练+微调、BatchNorm、残差连接、LSTM。**sigmoid 加剧**梯度消失(导数 ≤0.25)。
**易错**:误选"用 sigmoid"——sigmoid 是梯度消失的**原因**而非解药。
|
|
### 错题:激活函数
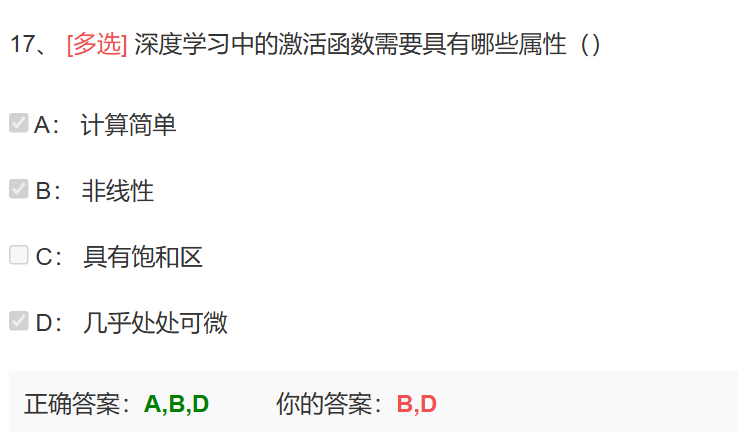
**错题反思**:激活函数的核心作用是**引入非线性**。线性激活使多层网络退化为单层,无法解决 XNOR 等线性不可分问题。
**易错**:误以为"层数多就能学到复杂函数"——没有非线性激活,再深也是线性。
|
|
### 错题:mini-batch
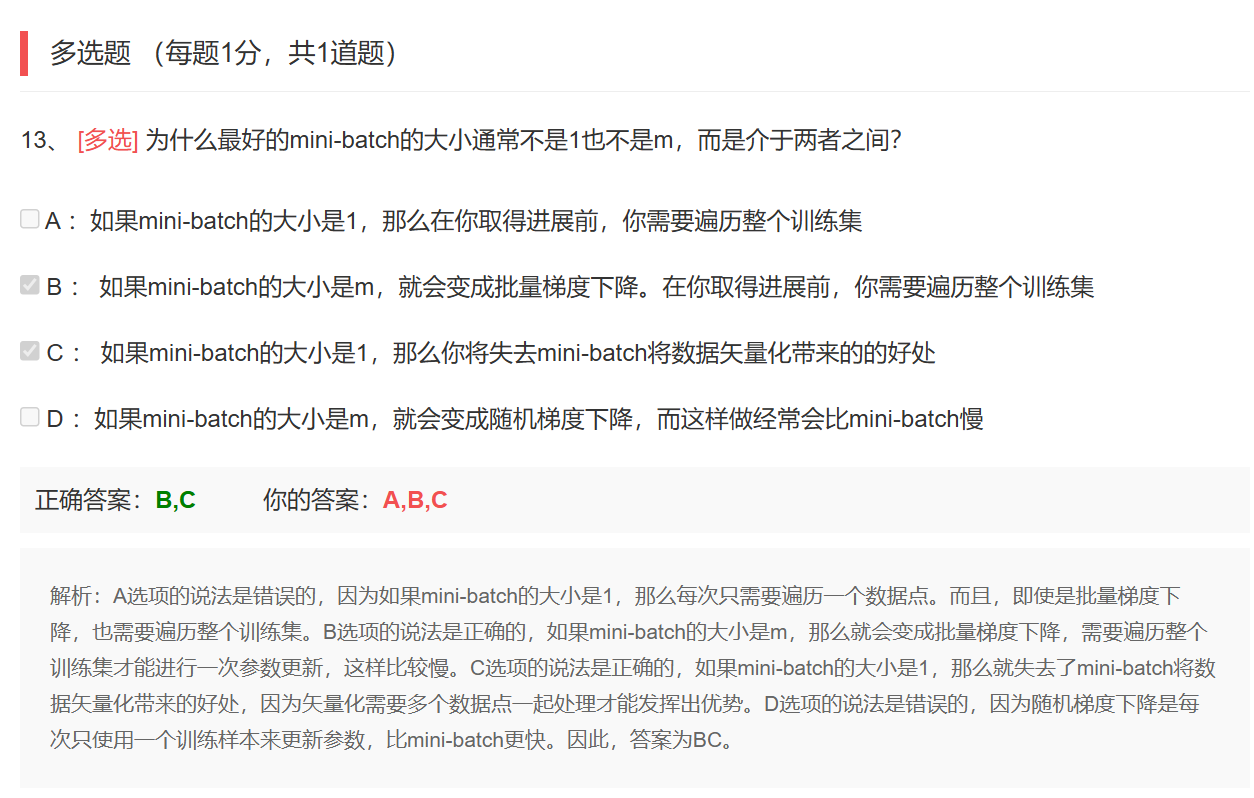
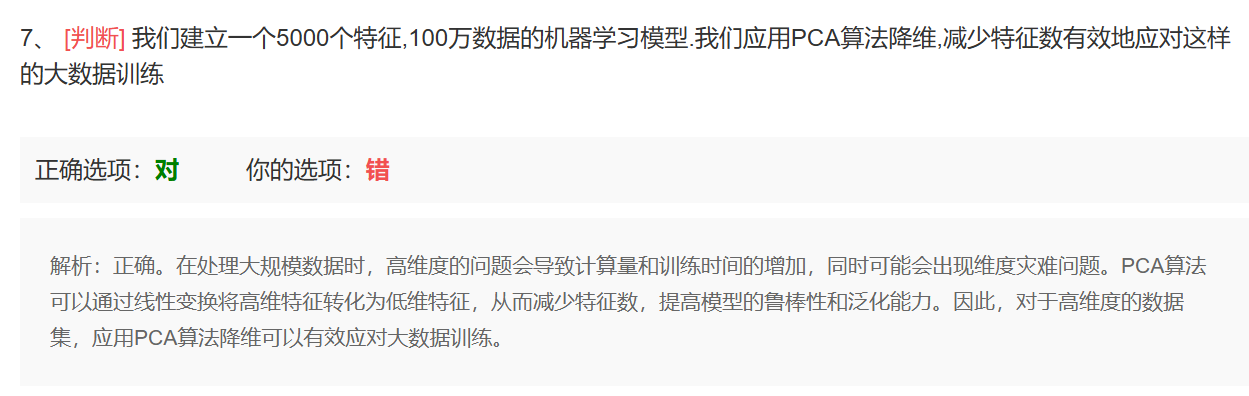
**错题反思**:mini-batch 大小权衡——batch=1 失去 GPU 向量化加速;batch=m 退化为批量 GD 每轮才更新。最优在 2 的幂(64/128/256)。
**易错**:误以为 batch 越大越好——超过某阈值后 GPU 利用率饱和,反而收敛慢。
|
|
### 错题:tanh
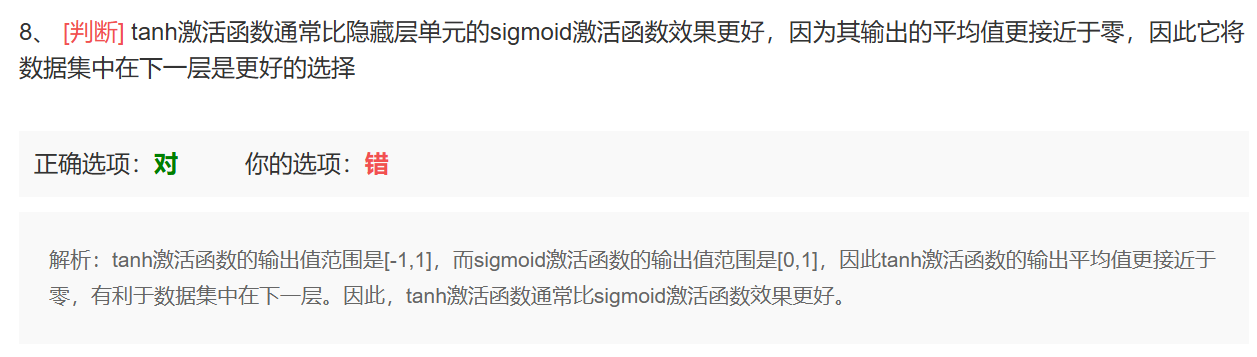
**错题反思**:tanh 优于 sigmoid 在隐藏层的原因——输出零中心化(均值 0 vs 0.5),梯度方向自由,收敛快。
**易错**:误以为 tanh 完全替代 sigmoid——输出层二分类(需 0~1 概率)仍用 sigmoid。
|
CNN与检测
|
### CNN 与检测知识点(错题复习)
**Inception 网络**:
- 核心思想:**并行多尺度卷积**(1×1, 3×3, 5×5, 池化)
- **1×1 卷积**用于**降维**(瓶颈层 Bottleneck)大幅省算
- 是**固定并行结构**,不是随机选择(区别于 Dropout)
- 加深网络不损害训练集表现
**人脸验证**:
- 任务:判断两张脸是否同一人(1:1)
- 挑战:one-shot 学习(每人可能仅 1 张)
- 解法:学习**相似度函数** d(img1,img2) + Siamese 网络
- 无需为新人重新训练,只算编码比对
**滑动窗口检测流程**(经典目标检测):
1. 选择窗口大小和步长
2. 在图像上滑动窗口
3. 每个窗口用分类器判断是否含目标
4. 步长大→省时但漏检;步长小→慢但精度高
- 现代方法(YOLO/FCN)用全卷积避免显式滑窗
|
|
### 错题:Inception 网络
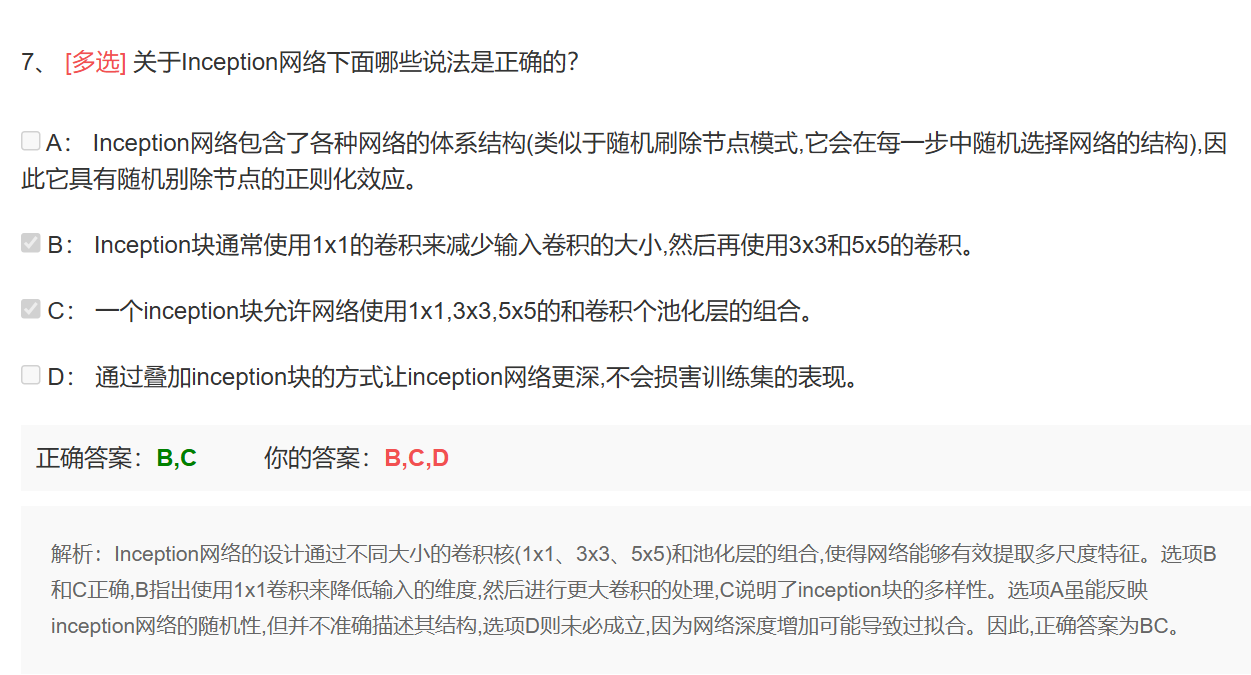
**错题反思**:Inception 正确说法——B(1×1 降维)、C(多尺度组合)、D(加深不损训练集)正确。A 错:Inception 不是随机选择结构,正则化效应属于 Dropout。
**易错**:把 Inception 的"多分支"误认为"随机选分支",实际是**所有分支并行**。
|
|
### 错题:人脸验证
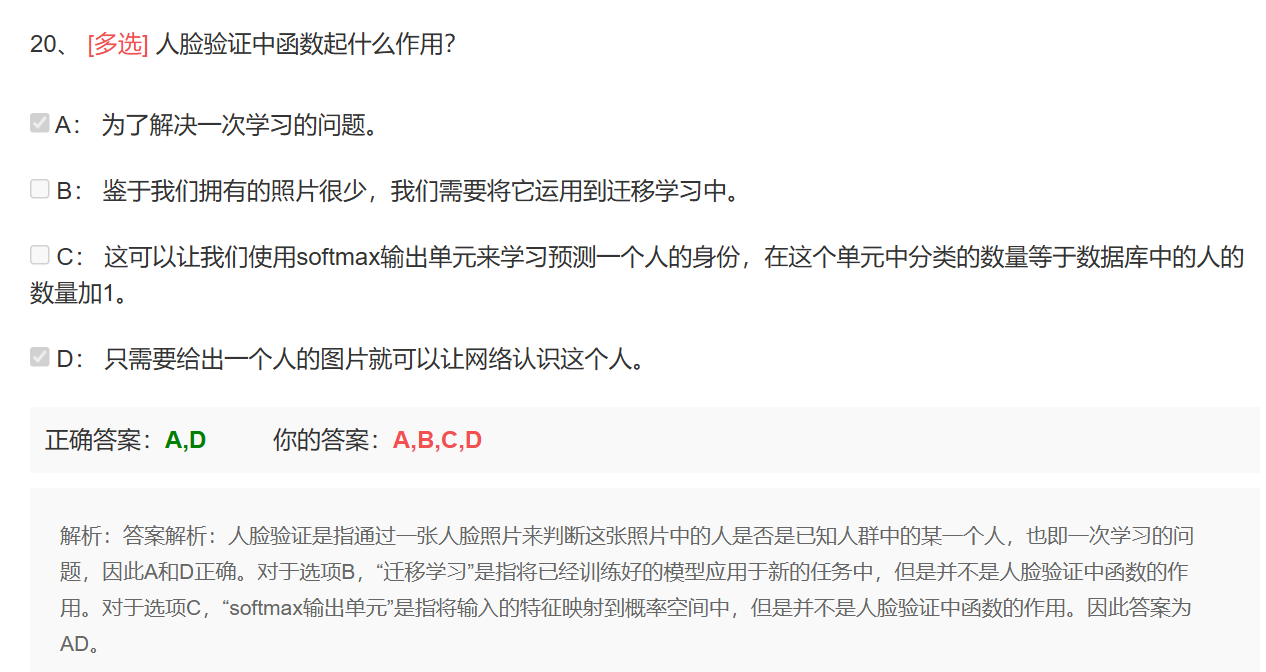
**错题反思**:相似度/距离函数在人脸验证中的作用——解决 one-shot 学习、支持迁移学习、一张照片即可识别。**无需**为每个新人重新训练。
**易错**:误以为每加入新人都要重训网络——实际只需计算新人编码与数据库比对。
|
|
### 错题:滑动窗口步骤
**错题反思**:滑动窗口的目标检测流程——选窗口/步长 → 滑动 → 分类 → 输出。步长与精度/成本权衡。
**易错**:误以为步长增大既提精度又降成本——实际步长大只降成本但**牺牲精度**(可能漏检)。
|
经典算法杂项
|
### 经典算法知识点(错题复习)
**GBDT(梯度提升决策树)**:
- **串行**训练:每棵树拟合前一棵的**残差**(负梯度)
- **标准 GBDT 用全部特征**(区别于随机森林的随机特征子集)
- 只有 **Stochastic Gradient Boosting**(GBDT 的随机变体)才用特征子集
- 代表实现:XGBoost、LightGBM、CatBoost
**t-SNE**:
- 非线性降维,主要用于**可视化**(降到 2D/3D)
- 代价函数基于 **KL 散度**(不对称)→ t-SNE 本质不对称
- 擅长保留**局部结构**(簇)
- 不适合作为通用降维(无显式变换,新样本需重算)
**Dropout**:
- 训练时随机丢弃神经元(概率 p)
- **Inverted Dropout**:训练时输出除以 p 补偿,**测试时不丢弃**
- 因此**测试时间与有无 Dropout 无关**
- 作用:防过拟合,强迫网络学冗余特征
**对比记忆**:
| 算法 | 确定性 | 关键机制 |
|------|--------|---------|
| GBDT | ✅ | 串行拟合残差 |
| 随机森林 | ❌ | 并行 + 随机特征 |
| t-SNE | ❌ | KL 散度(不对称) |
| Dropout | ❌ | 随机丢弃(仅训练) |
|
|
### 错题:GBDT
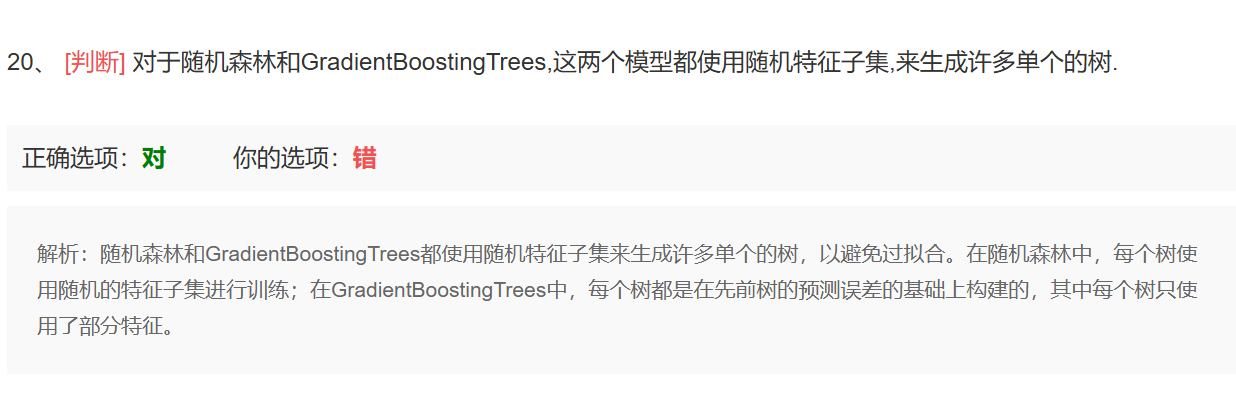
**错题反思**:GBDT 和随机森林**不都**用随机特征子集。随机森林用;**标准 GBDT 用全部特征**(只有 Stochastic GBDT 才用子集)。
**易错**:把"集成学习"统一视为"随机特征"——RF(Bagging)随机,GBDT(Boosting)标准下不随机。
|
|
### 错题:t-SNE
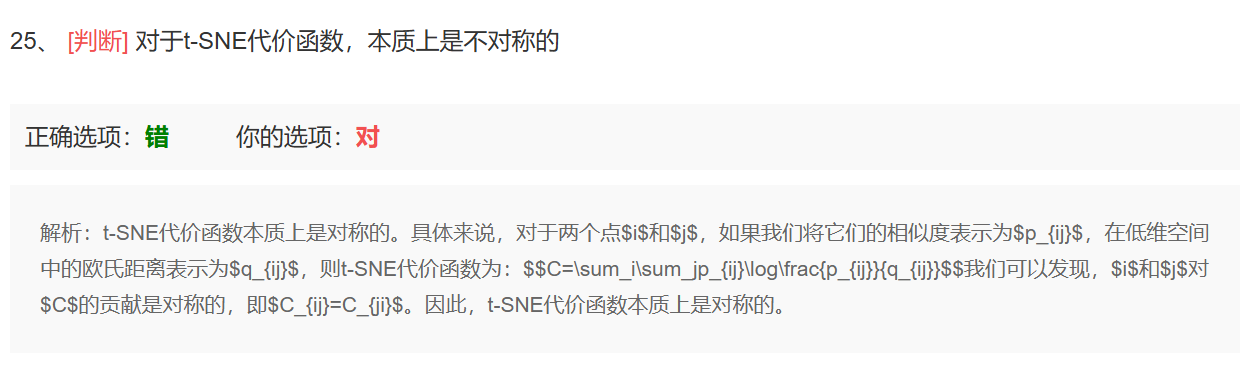
**错题反思**:t-SNE 代价函数基于 KL 散度,**本质不对称**。这导致其对"远距离"误判惩罚大(保局部簇),对"近距离"误判惩罚小。
**易错**:误以为 t-SNE 是对称的——KL(P\|Q) ≠ KL(Q\|P)。
|
|
### 错题:Dropout
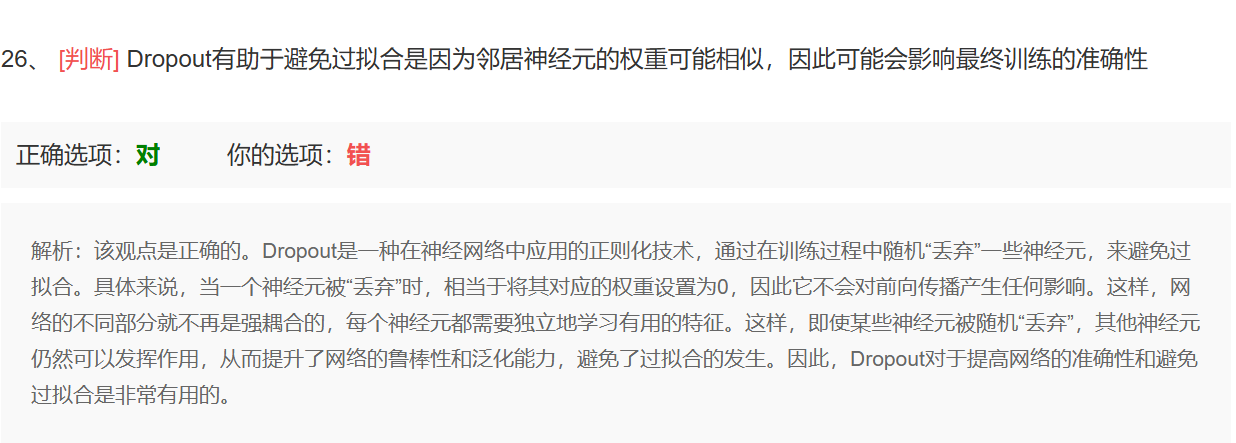
**错题反思**:Dropout 在测试时**不激活**(Inverted Dropout 测试用全部神经元),因此**测试时间不受影响**。只影响训练时间。
**易错**:误以为 Dropout 在测试时也丢弃神经元——实际测试用全部神经元,无需调整。
|
dl2 错题集
|
### dl2 错题集说明
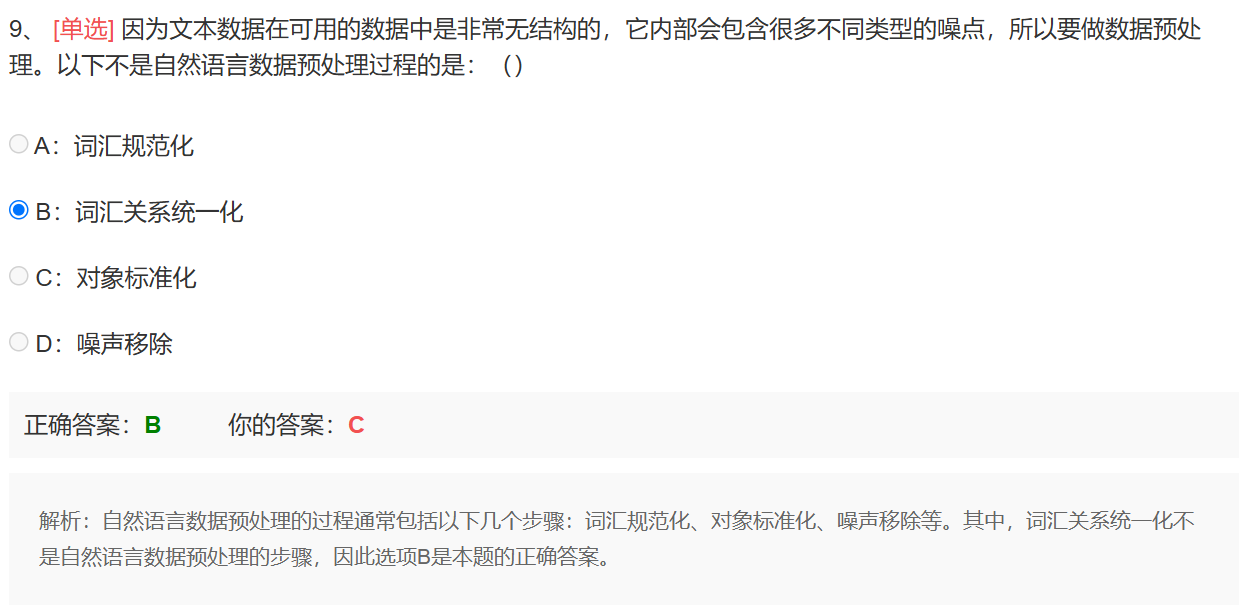
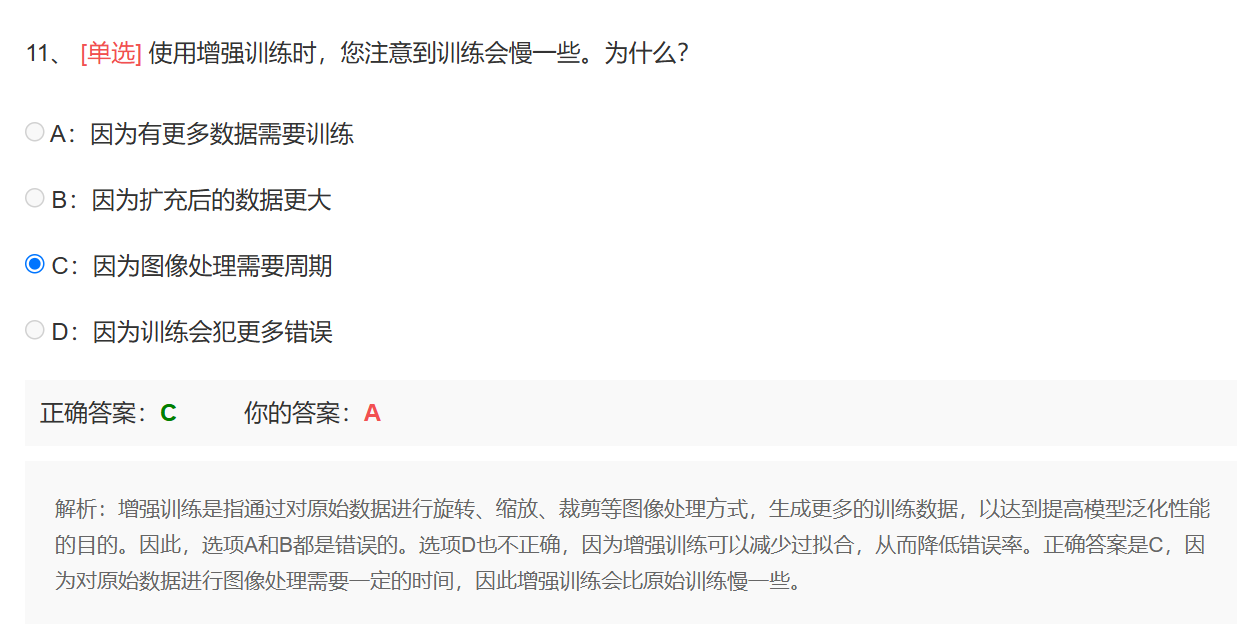
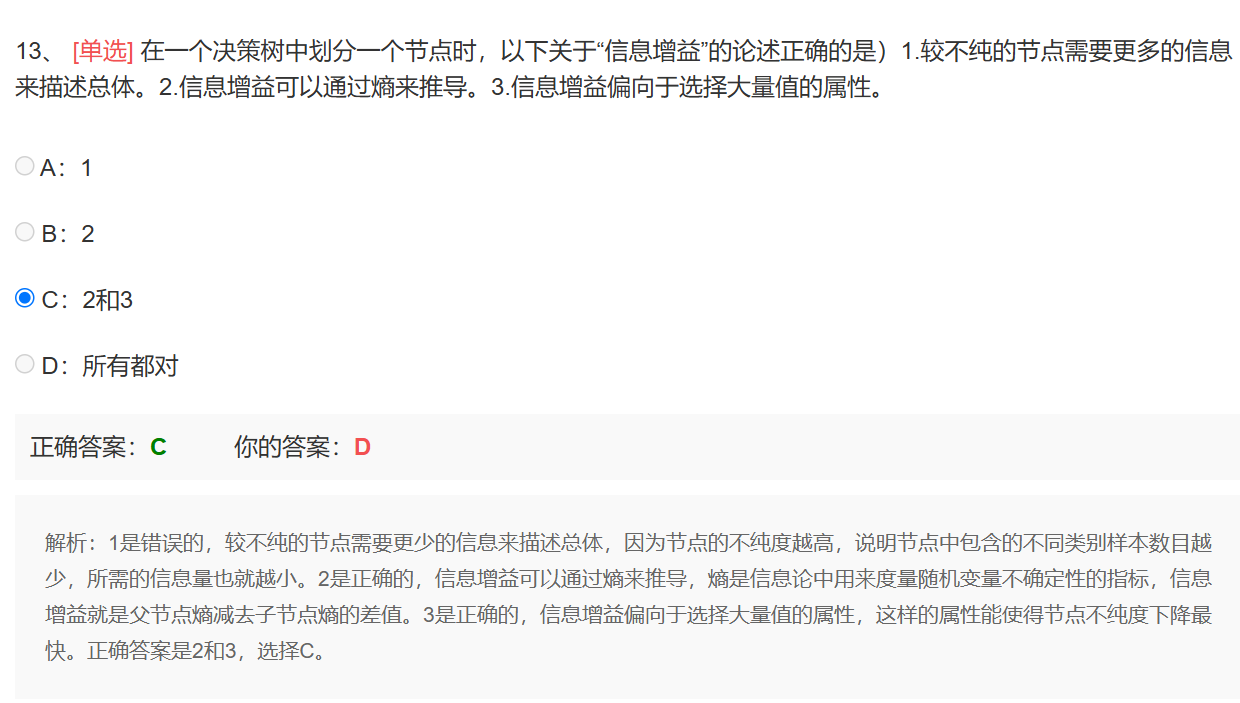
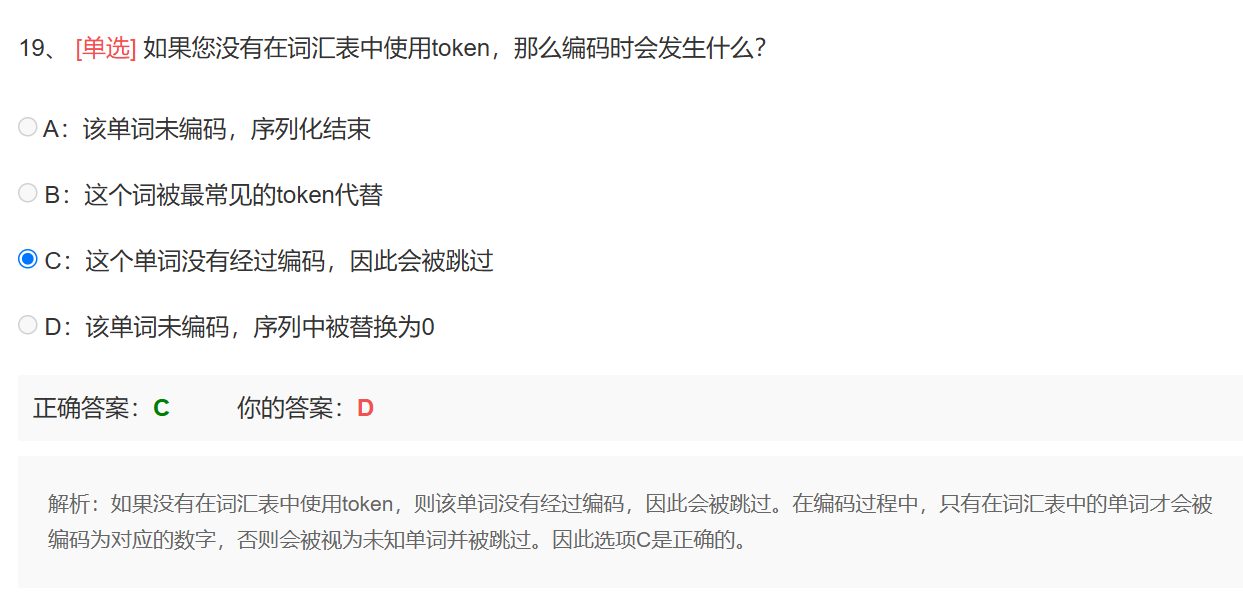
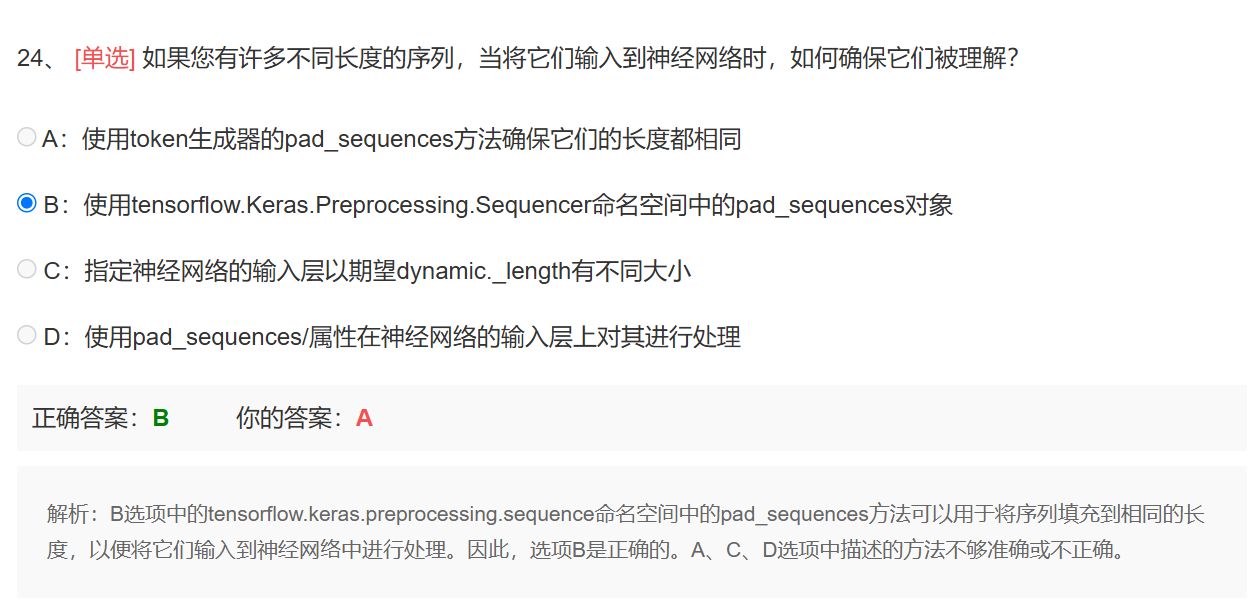
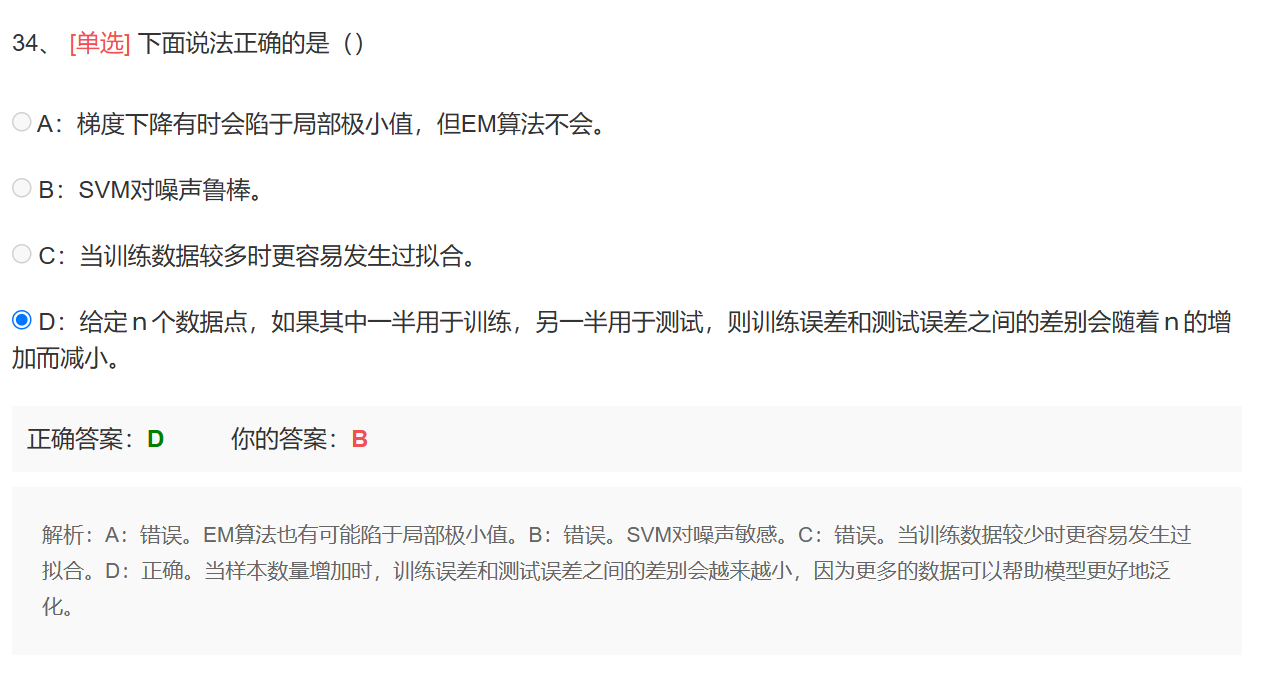
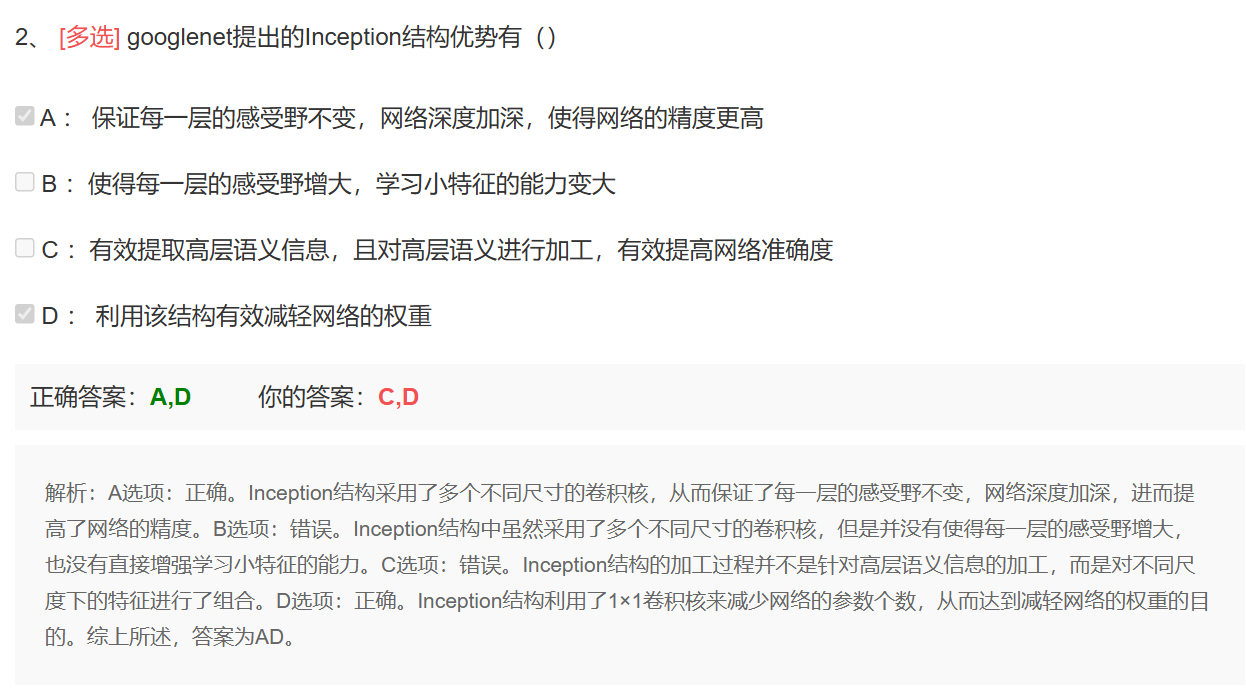
本章节收录 `dl2` 目录下 `error.md` 中记录的 **22 道错题截图**,按截图时段分 3 组展示。
- **第一组**(7 题):13:03-13:06 时段
- **第二组**(10 题):15:48-15:56 时段
- **第三组**(5 题):21:32-21:34 时段
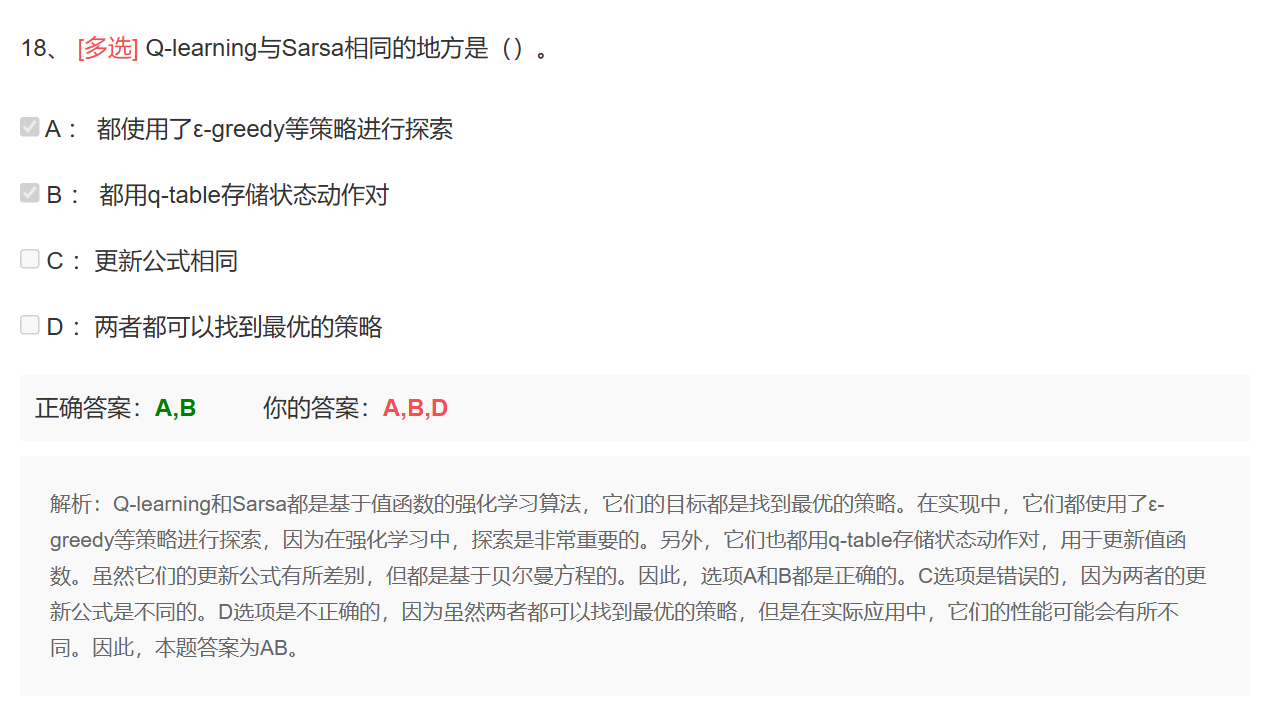
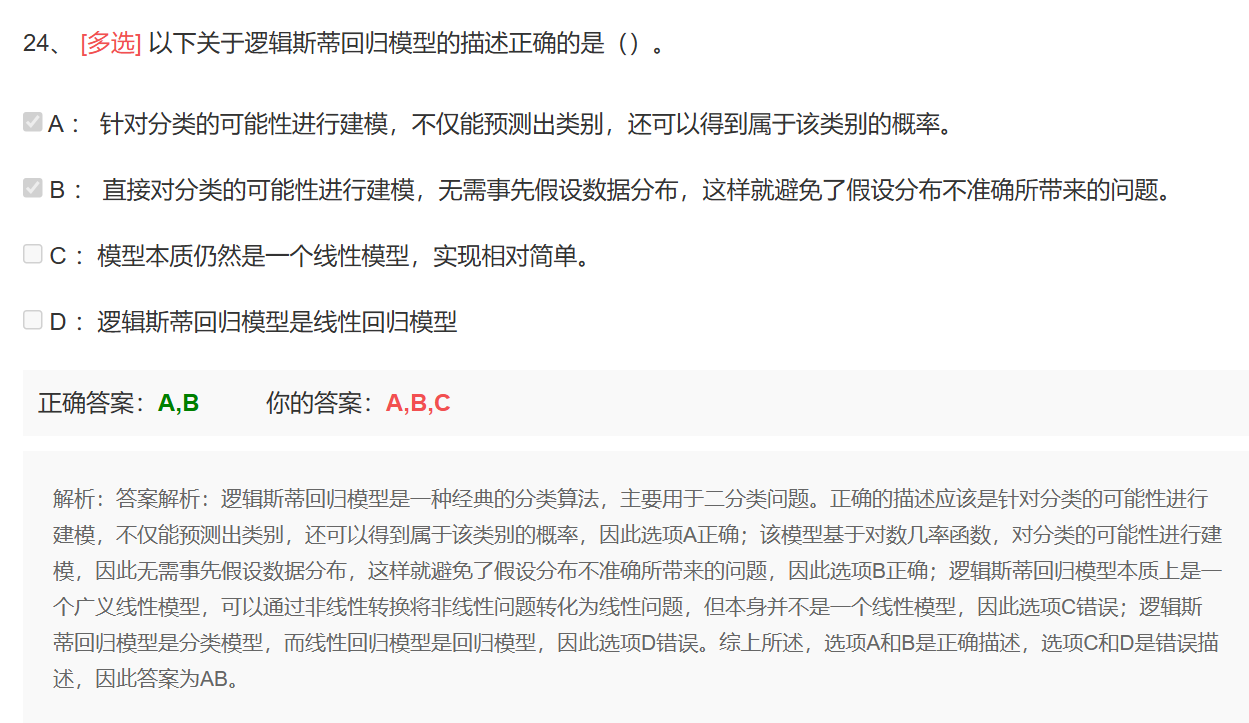
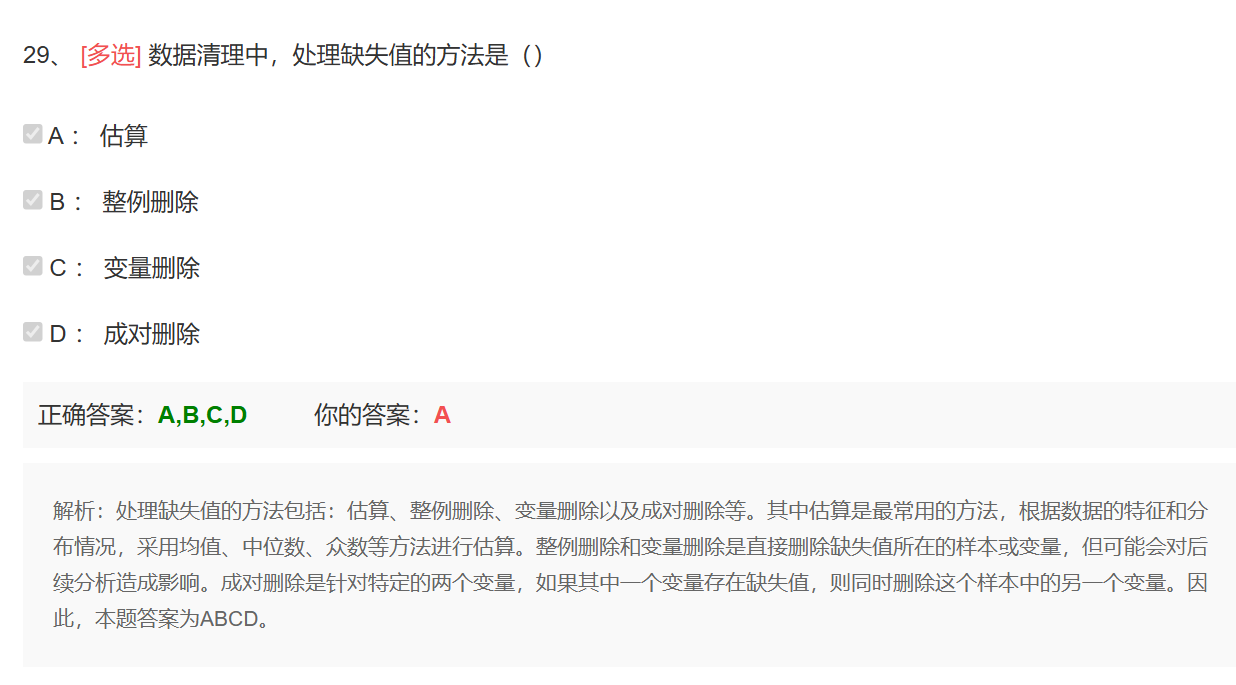
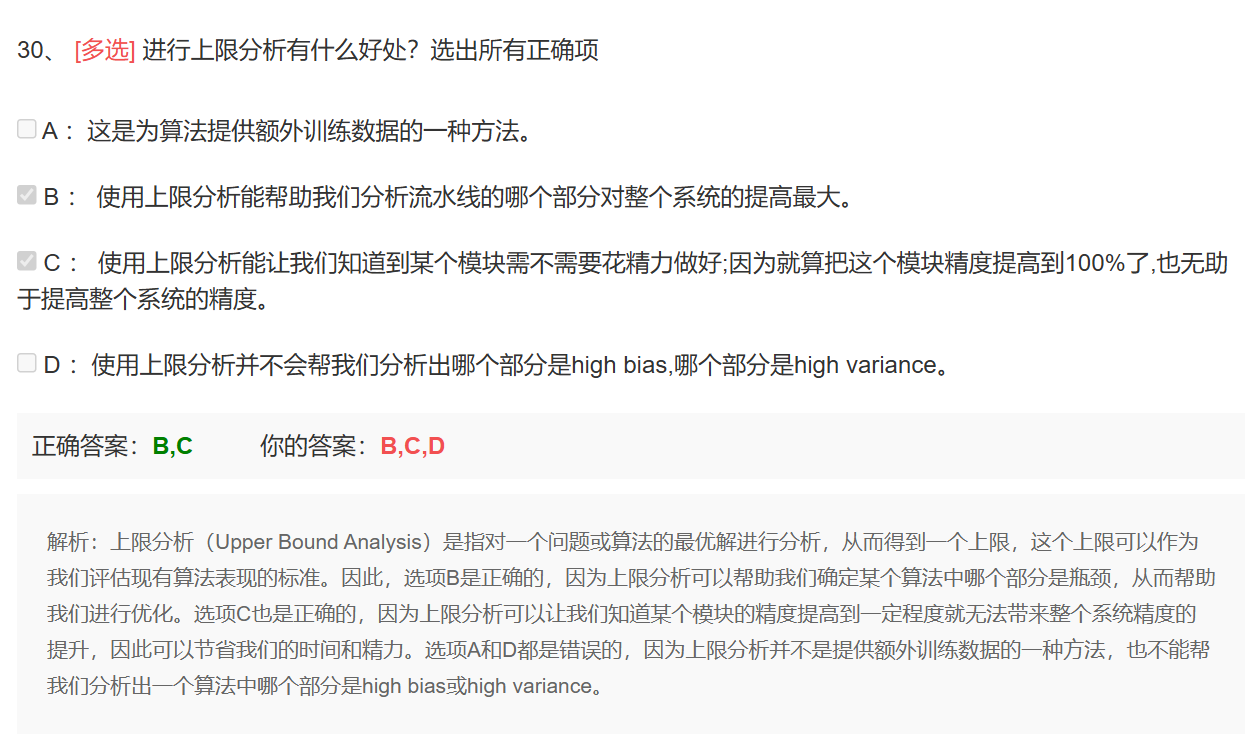
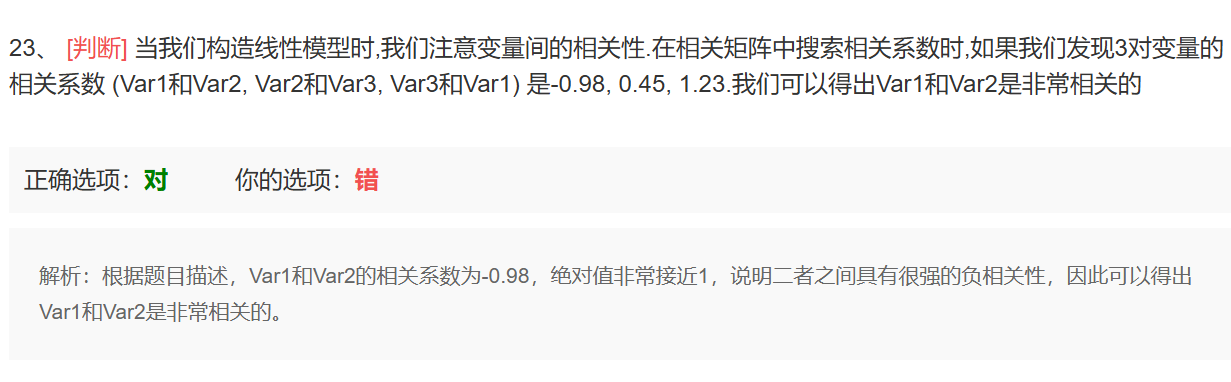
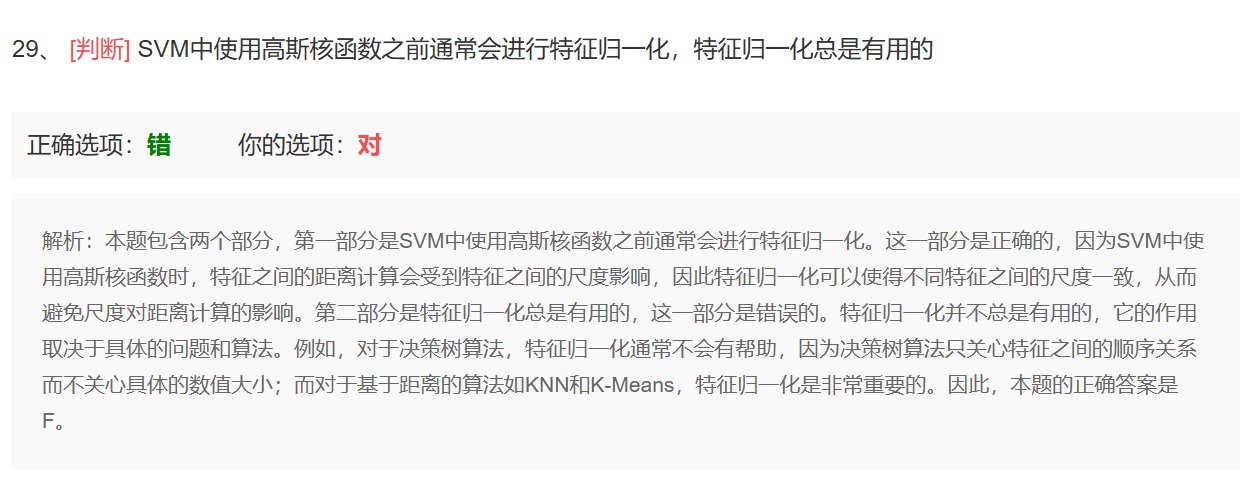
题目均为图片形式(无文字转录),直接查看截图即可。建议结合四大分类页面(机器学习 / 深度学习基础 / CV / NLP)的知识点 Tab 复习相关概念。
**复习建议**:每道错题先尝试自己作答,再对照截图中的标准答案;对易错知识点,回到对应分类页面的「知识点」Tab 加深理解。
|
|
### 第一组错题(13:03-13:06 时段,共 7 题)
|
|
### 第二组错题(15:48-15:56 时段,共 10 题)
 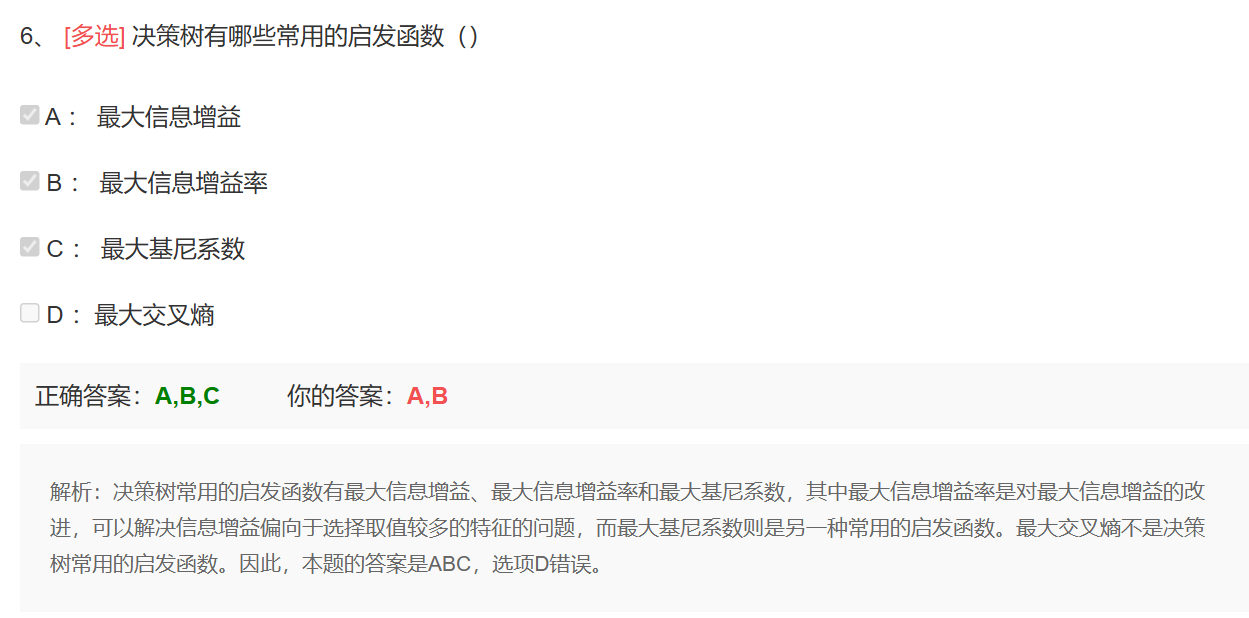 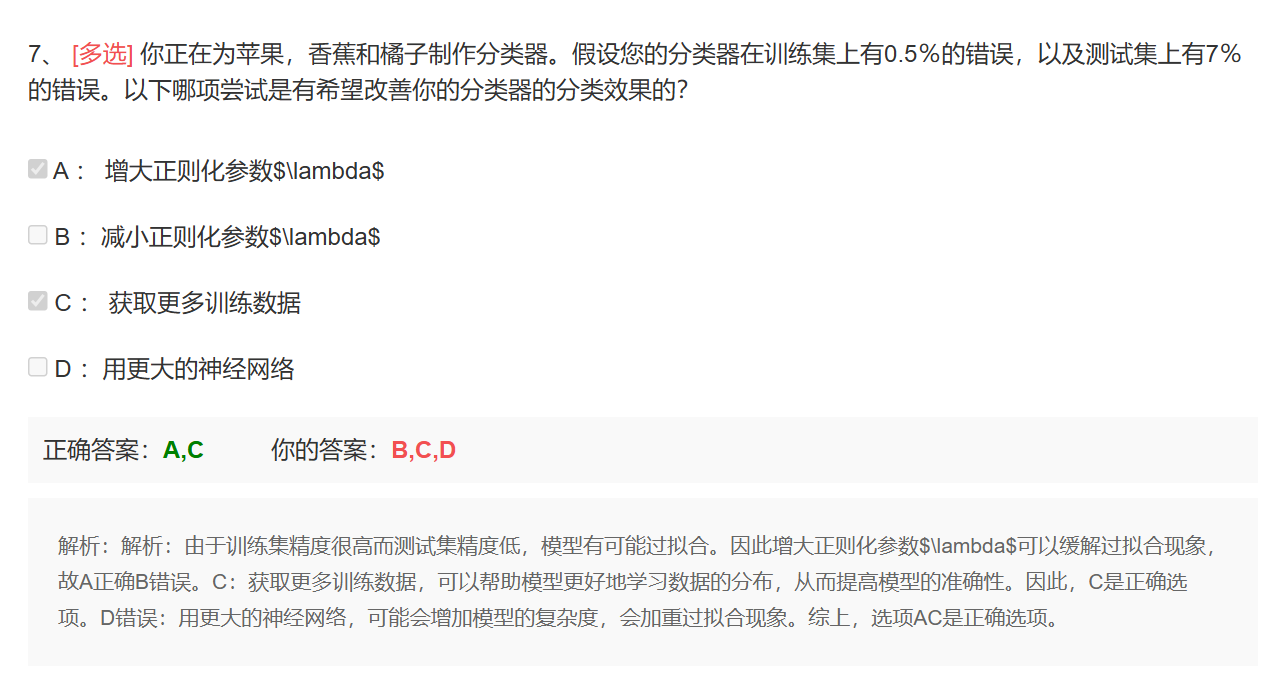 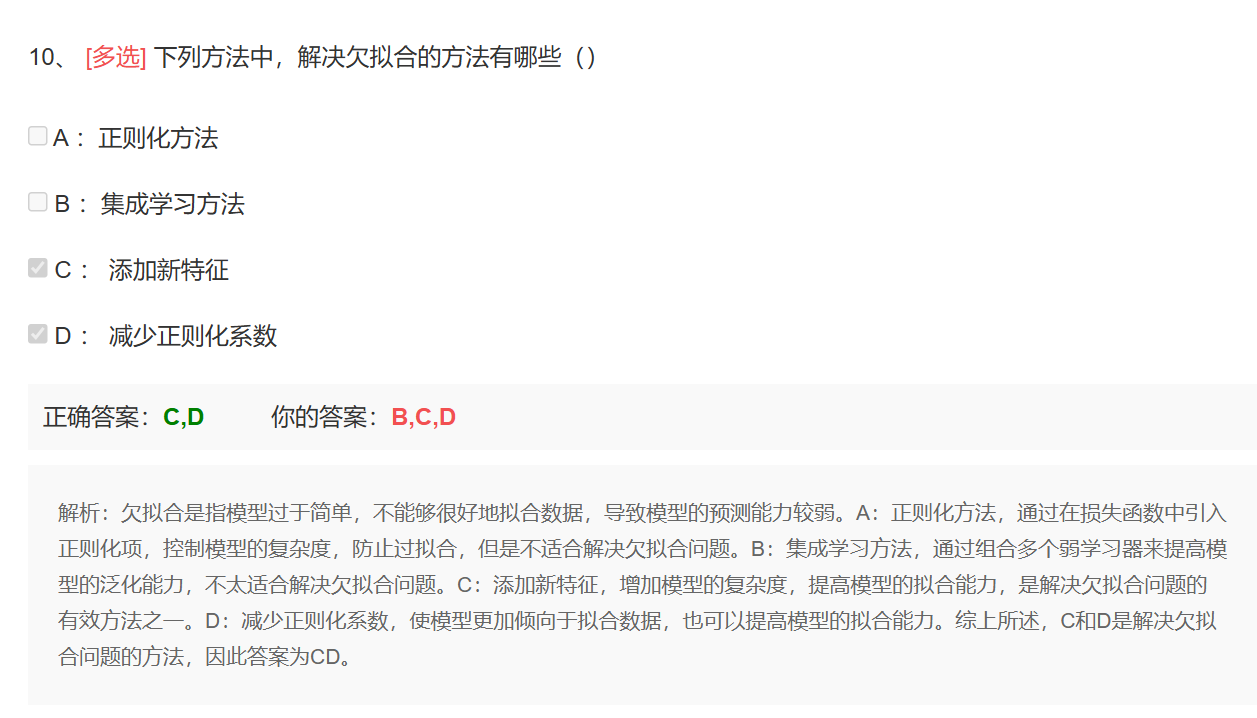 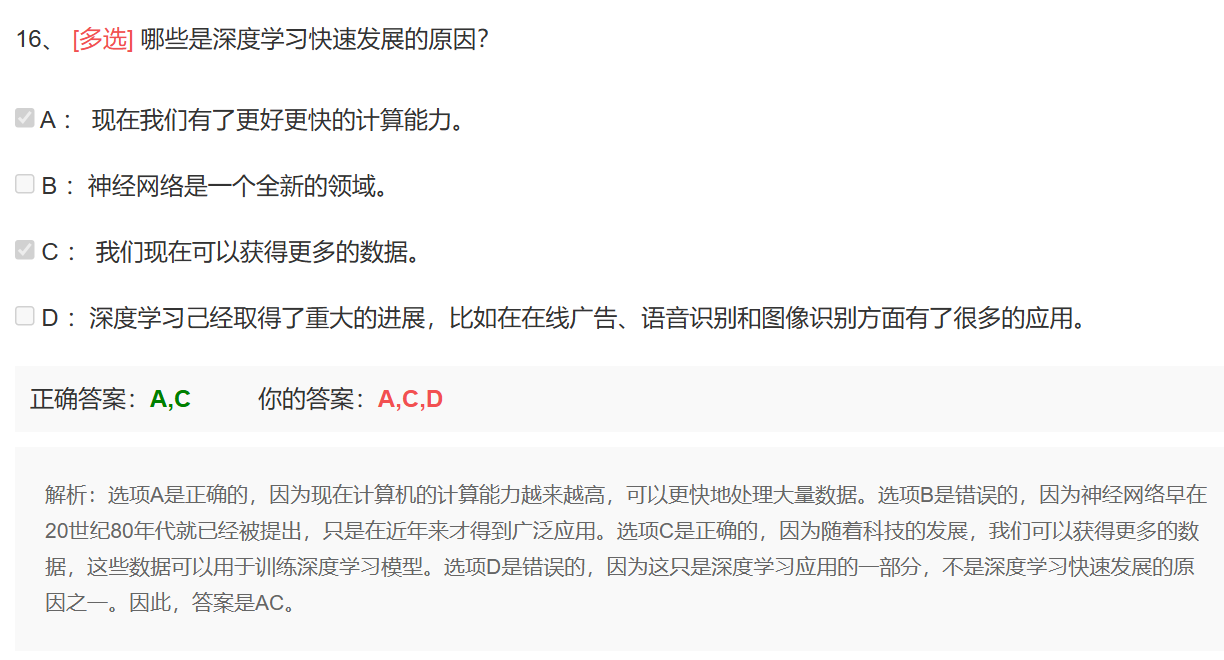     
|
|
### 第三组错题(21:32-21:34 时段,共 5 题)
|
参考