概述
|
早期的NLP除了分词外,还有以下内容
- 词性标注,名词,动词,形容词 ...
- NER,命名实体识别,人名,地名,公司名称等
- 信息提取
- 句法分析,语义分析
- 动名词短语挖掘
其处理方法更多是靠规则,工作量比较大
有了transformer,尤其是大模型之后,文本类工作基本由交大模型处理了...
- 甚至连分词都不用做了,扔给大模型一段文本,告诉大模型要做什么可以了
|
|
|
|
|
nn.Embedding
|
**num_embeddings
nn.Embedding中num_embeddings理论上指索引的个数,
但这有个前提,索引编码从0开始,并且一个连一个,
不能跳跃,一般情况下也不会跳跃,但跳跃也没有关系
实际上num_embeddings指提供的索引中的最大值
比如,本例如果num_embeddings低于8将报错,而实际上的索引个数只有4个
正常情况下索引编码都是从0开始,也无跳跃
nn.Embedding模板类生成的对象
import torch
from torch import nn
embedding = nn.Embedding(num_embeddings=6,embedding_dim=3,padding_idx=0)
batch_vec = torch.arange(start=0,end=6,step=1).reshape(2,3)
embedding(batch_vec).shape # torch.Size([2, 3, 3])
该对象将索引矩阵升了一维,所升的这一维就是索引所转向量的维度,
pytorch的维度是这样的(dim=0,dim=1),
升的这一维默认放在更高的维度,就是(dim=0,dim=1,dim=2)
随机性与有效性:起点是随机的,终点是有效的(但不一定是最好的,)
import torch
from torch import nn
embedding = nn.Embedding(num_embeddings=6,embedding_dim=3,padding_idx=0)
batch_vec = torch.arange(start=0,end=6,step=1).reshape(2,3)
embedding(batch_vec)
tensor([[[ 0.0000, 0.0000, 0.0000],
[-0.9986, 0.2995, -1.3050],
[-0.8627, 0.4689, -0.1170]],
[[-0.3458, 1.2517, -0.7372],
[ 0.4307, -0.3824, 0.1640],
[-1.2211, 1.0763, 1.4638]]], grad_fn=EmbeddingBackward0)
AI所要训练的参数是在定义nn.Embedding模板类时初始化的
nn.Embedding模板类在初始化参数时,是随机的,
这样随机地将一个整数索引转换为n维浮点向量,有效吗?
其实它的思想跟神经网络层的思想是一样的,参数随机初始化,
在训练时梯度下降,逐步向不随机的方向,就是标签的方向靠近
随机当然是无效的,训练后才有效
mytab('ulem_showme', 'tbem_showme');
IDF
概述
什么是IDF?**
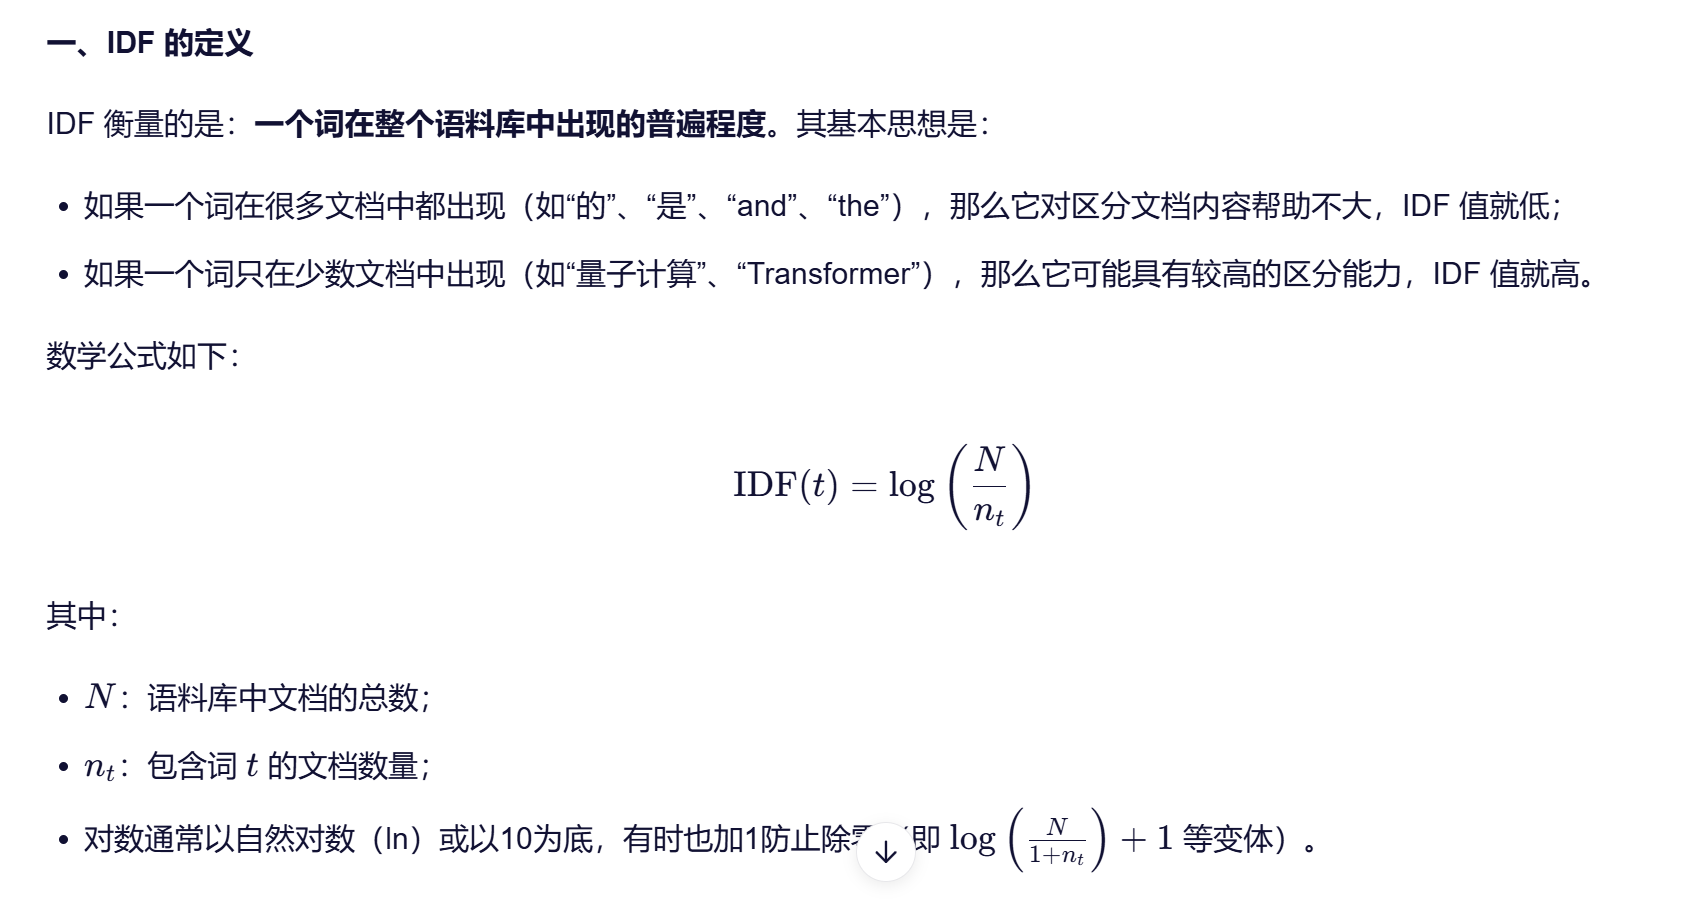
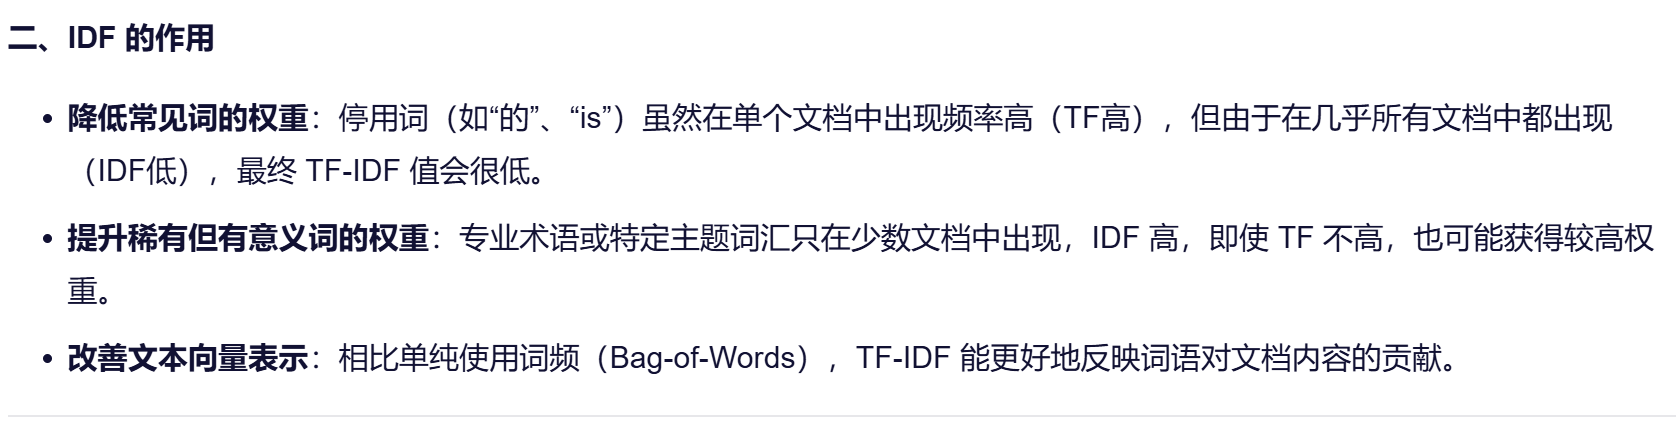
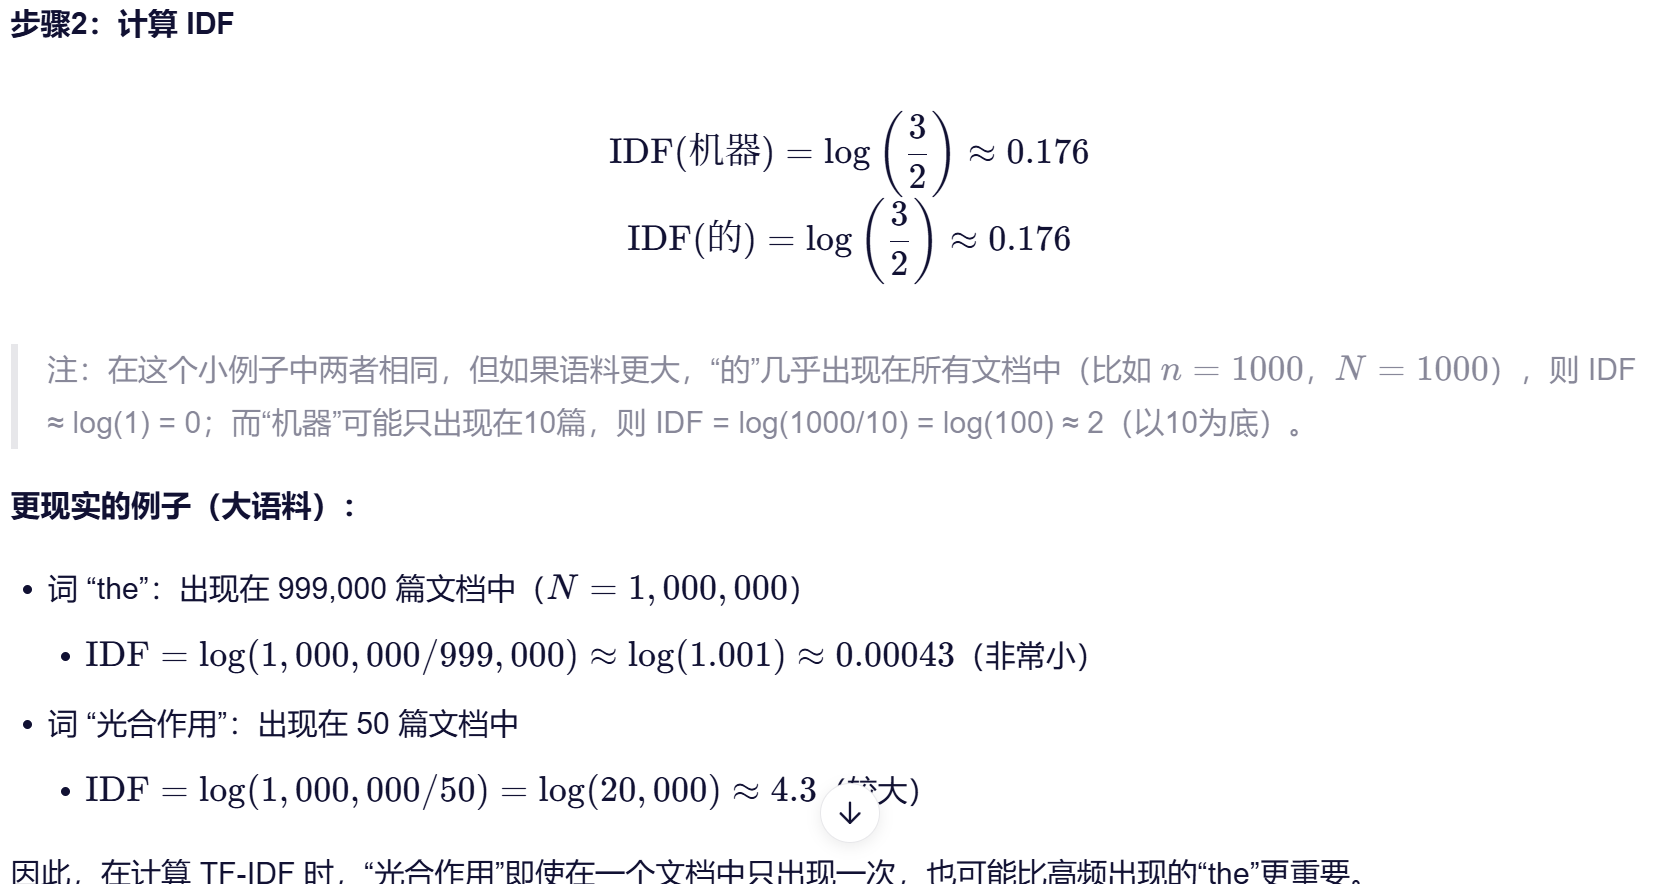
IDF,全称是逆文档频率。它的核心思想是:一个词语在越多的文档中出现,它的重要性就越低;反之,一个词语在越少的文档中出现,它的重要性就越高。
IDF是TF-IDF算法中的一部分,TF-IDF用于评估一个词语对于一个文档集或一个语料库中的其中一份文档的重要程度。
TF:词频,衡量一个词在单个文档中出现的频率。一个词在文档中出现的次数越多,TF值越高。
IDF:逆文档频率,衡量一个词的普遍重要性。一个词在所有文档中出现的次数越多,IDF值越低
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
bm25
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
参考