微调方法
|
**标签数据微调、基于特征的微调、蒸馏、基于适配器的微调、提示语微调
标签数据微调:准备自己的打好标签的训练数据,再次训练大模型;
特征微调:
在冻结现有大模型网络参数的基础上,添加一些自己的代码,
可以是添加新的网络结构,或者是在原矩阵的基础上拼接一段自己的矩阵,
重新训练时只改变自己新加的参数,不改变原大模型的参数;
蒸馏:向大模型提问,得到答案,形成训练集,来训练自己的小模型
适配器微调:不改变大模型参数,针对某个场景进行的特征微调,场景不同,适配器不同;
提示词微调:
自然语言的细化,说成大模型能理解的语言,
主要特点是,根据语义不断拆分细化,把大模型当作“一个完全不明白你意思的 人”,
最好是一句话只包括一个不可再拆分的语义,所有潜台词隐含的意思全部转换为明明白白的文字,
这样大模型就能更好地理解你的意思
GPT-3.5-Turbo微调:除了前面通用的微调方法,这是还支持JSON输入
微调方法有多种,这是指实际能解决问题的方法,
但实际上,普通人问你会不会微调指的是 会不会调整大模型的参数
- 隐含的期望是你能不能在垂直领域训练一个好用,免费,公司自己的大模型
暂时不说怎么调整参数,但调完参数之后,必须得重新训练,这有两个问题
- 模型训练,这是算法工程师该干的事,涉及大量算法类别的基础知识,虽然不难,但...那是算法层次的
- 效果,微调之后的效果通常不好,大模型重新训练的代价非常之大,并且最后很可能会面临一个较差的效果
- 为什么会这样呢?因为它破坏了原大模型的参数结构
- 原结构下效果是好的,否则也不好意思拿出来,
- 但结构改变之后,是好是坏不好说,通常是坏的
- 最不能破坏的是LLM的语义理解能力
-
所以,你最好得会深度学习算法的一些基础
吴恩达讲AI
https://www.zhihu.com/education/video-course/1556316449043668992
李沐讲深度学习
https://www.zhihu.com/education/video-course/1647604835598092705
微调的场景
如果不是极其特殊的场景,那么就不需要微调了
3版本以上的LLM都具有解决问题的能力
如果一个场景真的非常特殊,通用的能力真的无法满足业务场景,可以微调
- 微调之后,增加了处理特殊场景的能力
- 损失了一部分通用场景的能力
微调
输出的格式,风格
- 如果你感觉现在的对话风格比较生硬,想口语化一些
- 口语化的过程,也是让LLM做的,抽取出来,口语化,再替换回去
- 开头与结束再加一些友好的问候语
- 意思是,在数据上补充了这个能力,
- 放回去的时候,有时候,上下文不连贯,再让LLM对其处理一下,使之连贯起来
补充多轮对话
- 原来只有单轮对话,这样的数据训练出来的模型,多轮对话能力就比较弱,或者说是无法预期
- 需要补充多轮对话进去,进行训练
同义词处理
- 简称,缩写,口语化的指代等等,这些数据也补充进去
- 如果原始数据中没有这些,那么用这些数据训练出来的模型,
- 就无法将口语化简化的叫法与实际的名称对应起来
边界处理
- 有些特征是有范围的,比如价格,要举例让模型学习这些边界
RNN, CNN, 注意力,transformer,NLP,transformer,
chatglm微调示例
https://github.com/THUDM/ChatGLM3/blob/main/finetune_demo/finetune_hf.py
tool 拼接的早期版本
https://github.com/THUDM/ChatGLM3/blob/4568c635e686e8e2053568d041f36c884cab328a/finetune_demo/preprocess_utils.py
root@llm:~# pip install peft
PEFT
大模型PEFT的全称是Parameter-Efficient Fine-Tuning,即参数高效微调。
这是一种针对大型预训练模型(如LLM模型)的微调技术,由Hugging Face开源。
PEFT可以在不微调模型所有参数的情况下,
通过微调少量参数就达到接近微调全量参数的效果,
使得在GPU资源不足的情况下也可以微调大模型。
PEFT集成了多种微调大模型的方法,如
Prefix Tuning(前缀微调)、
Adapter Tuning(适配器微调)、
LoRA(Low-Rank Adaptation,低秩适应)等,这些方法各有特点,
但共同之处在于它们都能以较小的参数调整量实现较好的模型性能提升。
具体来说,PEFT的应用场景包括但不限于:
序列分类任务:如文本分类、情感分析等。
标记分类任务:如命名实体识别、词性标注等。
文本生成任务:如机器翻译、文本摘要等。
<a href="http://www.huggingface.co" target="_blank">http://www.huggingface.co</a>
模型库,常见模型,尤其是transformer系列
# pip安装
pip install requests
pip install datasets #huggingface
pip install transformers # 安装最新的版本
pip install transformers==4.30 # 安装指定版本
# conda安装
conda install -c huggingface transformers # 只4.0以后的版本
from peft import get_peft_model, LoraConfig, TaskType, PeftModel
def load_lora_model(model_args, peft_args):
# 加载预训练的chatglm3-6b的tokenizer和model
tokenizer = AutoTokenizer.from_pretrained(model_args.model_name_or_path, trust_remote_code=True)
model = AutoModel.from_pretrained(model_args.model_name_or_path, trust_remote_code=True)
model = model.half()
# 使用peft库配置lora参数
peft_config = LoraConfig(
task_type=TaskType.CAUSAL_LM,
inference_mode=False,
r=peft_args.lora_rank,
lora_alpha=peft_args.lora_alpha,
lora_dropout=peft_args.lora_dropout,
target_modules=["query_key_value"],
)
model = get_peft_model(model, peft_config).to("cuda")
model.enable_input_require_grads()
model.is_parallelizable = True
model.model_parallel = True
model.config.use_cache = False
return tokenizer, model
# 使用peft库配置lora参数
peft_config = LoraConfig(
task_type=TaskType.CAUSAL_LM,
inference_mode=False,
r=peft_args.lora_rank,
lora_alpha=peft_args.lora_alpha,
lora_dropout=peft_args.lora_dropout,
target_modules=["query_key_value"],
)
r=peft_args.lora_rank,
设置秩的大小,8,16
lora_alpha=peft_args.lora_alpha,
超参数,一般是32,64
lora_dropout=peft_args.lora_dropout,
填写dropout函数舍弃的概率值,通常不超过0.5
target_modules=["query_key_value"],
query_key_value表示在QKV上都加,加上那两个低秩矩阵相乘后的矩阵
model = get_peft_model(model, peft_config).to("cuda")
get_peft_model把配置注入了模型,实际上分以下几步
- 从模型中取出现有参数
- 把低秩矩阵相乘后的矩阵参数加到模型参数上
- 让模型重新加载新参数并返回模型
- 需要注意的是
- 重新训练时,原模型的参数是不变的,被冻结
- 每次变化的是低秩矩阵的参数
- 相乘以后,加到原模型参数上,使最终结果发生微小变化
- 这就是LoRA微调,是轻量级微调一个常用方法
task_type=TaskType.CAUSAL_LM:
这个参数指定了任务类型。TaskType.CAUSAL_LM表示这是一个因果语言模型(Causal Language Model)任务,也就是通常所说的自回归语言模型(Autoregressive Language Model)。这种模型会根据前面的文本生成接下来的文本,如GPT系列模型。
inference_mode=False:
这个参数通常用于控制模型是否处于推理模式。False表示当前配置不是为推理而设置的,可能是为了训练或微调。在推理模式下,模型可能会关闭某些仅在训练时需要的特性,如dropout等,以提高推理速度和效率。
r=peft_args.lora_rank:
r参数是LoRA技术的核心之一,它表示低秩矩阵的秩(rank)。LoRA通过在预训练模型的某些层上添加可训练的低秩矩阵来实现参数高效的微调。秩的大小控制了这些低秩矩阵的复杂度,从而影响了模型的表达能力和微调所需的计算资源。peft_args.lora_rank是从某个参数集合(可能是命令行参数、配置文件等)中获取的秩的值。
lora_alpha=peft_args.lora_alpha:
lora_alpha是LoRA微调中的一个超参数,用于控制低秩矩阵对原始模型参数的影响程度。
它通常是一个标量,用于缩放低秩矩阵的权重。
较大的alpha值会使低秩矩阵对模型的影响更大,反之亦然。
peft_args.lora_alpha是从参数集合中获取的alpha的值。
lora_dropout=peft_args.lora_dropout:
lora_dropout是一个可选参数,用于在LoRA微调过程中应用dropout。
Dropout是一种正则化技术,通过在训练过程中随机丢弃一部分神经元的输出来减少模型的过拟合。
在LoRA微调中,虽然主要目标是微调低秩矩阵,
但也可以在低秩矩阵的权重上应用dropout来进一步增加模型的泛化能力。
peft_args.lora_dropout是从参数集合中获取的dropout率。
target_modules=["query_key_value"]:
target_modules参数指定了LoRA微调将应用于哪些模型组件。
在这个例子中,它设置为["query_key_value"],
这通常意味着LoRA微调将应用于Transformer模型中的查询(query)、键(key)和值(value)矩阵。
这些矩阵是Transformer模型中自注意力机制的核心部分,对于模型的性能至关重要。
通过在这些矩阵上应用LoRA微调,可以在不改变预训练模型大部分参数的情况下,
针对特定任务对模型进行定制和优化。
mytab('ulchatglm1', 'tbchatglm1');
数据集
CrossWOZ
数据集
汉语对话:酒店,餐饮,打车,地铁等跨领域对话
https://github.com/thu-coai/CrossWOZ
其中的酒店预订部分
https://github.com/thu-coai/CrossWOZ/blob/master/data/crosswoz/database/hotel_db.json
数据增强
针对同一个事物/问题,不同风格的提问
- 客观,死板
- 口语,灵活
这套数据集,是人编写的,按指定格式编写的,对原生的对话进行了整理
- 但就对话而言,是分场景,语气,地域风格的,
- 所以,当不同的人/群体使用时,可能还需要补充
其实就是系统性,全方位,全场景覆盖,如果哪个地方没有覆盖到,就可能在哪个地方出问题
所以,关于LLM知识缺陷的补充,已经开始由测试团队负责了,
这正是测试团队的日常工作,由测试团队测试出系统的缺陷,由开发团队完善补充,
然后不断重试这个过程
参考代码
data_augmentation
augmentation 英/ˌɔːgmɛnˈteɪʃ(ə)n/ 美/ˌɑgmɛnˈteɪʃən/
n.增强;扩大;增加;增长;加强;提高
mytab('ulwfinedataset', 'tbwfinedataset');
容器构建
实验环境
web调试
重新训练
预测
监控
chatglm3和llama3的权重下载命令脚本
训好的checkpoints
训练所需的数据集和代码
ssh -p 10024 root@connect.westb.seetacloud.com
rsync -e 'ssh -p10024' -avP root@connect.westb.seetacloud.com:/root/autodl-tmp /root/
rsync -e 'ssh -p10024' -avP root@connect.westb.seetacloud.com:/root/miniconda3 /root/
EFJLX0etnAwc
sudo apt update
sudo apt install less
PATH=/root/miniconda3/bin:/usr/local/bin:/usr/local/nvidia/bin:/usr/local/cuda/bin:/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin
export REQUESTS_CA_BUNDLE=/etc/ssl/certs/ca-certificates.crt
# cat init_env.sh
#! /usr/bin/env bash
echo "拷贝checkpoint到数据盘"
cp -r /root/checkpoints /root/autodl-tmp
echo "完成"
cd /root/autodl-tmp
echo "开始从modelscope拉取模型预训练权重"
echo "下载chatglm3-6b权重,预计十几分钟"
git lfs install
GIT_LFS_SKIP_SMUDGE=1 git clone https://www.modelscope.cn/ZhipuAI/chatglm3-6b.git
cd chatglm3-6b/
git checkout a8079d5ed73707fb7d5aadc4a0da70771c4e7bdb
git lfs fetch --include="tokenizer.model"
git lfs checkout tokenizer.model
git lfs fetch --include="*.bin"
git lfs checkout *.bin
rm -rf .git # 清除掉.git目录,避免数据盘空间不足
cd /root/autodl-tmp/
echo "下载llama3-8b权重,预计十几分钟"
git clone https://www.modelscope.cn/LLM-Research/Meta-Llama-3-8B-Instruct.git
cd Meta-Llama-3-8B-Instruct
rm -rf .git # 清除掉.git目录,避免数据盘空间不足
cd /root/autodl-tmp/
echo "完成"
echo "从github拉取finetune代码,如网络不稳定导致拉取失败,可以手动重复尝试:"
echo "git clone https://mirror.ghproxy.com/https://github.com/agiclass/fine-tuning-lab -b v6"
# 进入finetune代码目录中,拉取一下最新代码
cd /root/autodl-tmp/
git clone https://mirror.ghproxy.com/https://github.com/agiclass/fine-tuning-lab -b v6
echo "已准备就绪,可以开始做训练实验或运行webui demo了"
finetune的代码托管在github上,大家可以去同步拉取(也欢迎大家来star噢),
地址是 https://github.com/agiclass/fine-tuning-lab 代码在 v6 分支上。
从github拉取finetune代码,如网络不稳定导致拉取失败,可以手动重复尝试
```bash
cd /root/autodl-tmp/
# 如果网络不畅通可以使用ghproxy来代理从github同步代码
# 或从实验室中拿到的已打包好的代码包然后手动传到autodl服务器上
git clone https://mirror.ghproxy.com/https://github.com/agiclass/fine-tuning-lab -b v6
```
然后到web demo的目录加载并运行模型
```bash
cd /root/autodl-tmp/fine-tuning-lab/web_demo/
bash chatglm3_lora.sh
## 其他的也是同理
# bash chatglm3_origin.sh
# bash chatglm3_pt2.sh
# bash llama3_qlora.sh
```
实验指导
http://127.0.0.1:8888/notebooks/lecture-notes/14-fine-tuning-02/lab/index.ipynb
web调试
cd /root/autodl-tmp/fine-tuning-lab/web_demo/
bash chatglm3_lora.sh
## 其他的也是同理
# bash chatglm3_origin.sh
# bash chatglm3_pt2.sh
# bash llama3_qlora.sh
-----------------------------------------------------------------------------
cp chatglm3_lora.sh chatglm3_lora2.sh
/root/autodl-tmp/fine-tuning-lab/chatglm3/output/hotel_lora-20240728-124303/checkpoint-3000
# cat chatglm3_lora2.sh
#!/bin/bash
MODEL_DIR="/root/autodl-tmp/chatglm3-6b"
CHECKPOINT_DIR="/root/autodl-tmp/fine-tuning-lab/chatglm3/output/hotel_lora-20240728-124303/checkpoint-3000"
CUDA_VISIBLE_DEVICES=0 python webui_chatglm3.py \
--model_name_or_path $MODEL_DIR \
--checkpoint_path $CHECKPOINT_DIR \
--lora_rank 8 \
--lora_alpha 32 \
--lora_dropout 0.1
./chatglm3_lora2.sh
将服务的端口映射到指定6006上
若上面的方法无法使用,则尝试下面的方法
# 比如上一步从autodl控制台上复制下来的ssh命令是:
# ssh -p 17844 root@connect.westb.seetacloud.com
# 则这一步在前面加上 -L 6006:localhost:6006
# !!! 注意把这里的地址和端口换成你自己的 !!!
ssh -L 6006:localhost:6006 -p 17844 root@connect.westb.seetacloud.com
数据目录 fine-tuning-lab/data
cd chatglm3
sh lora_train.sh
## 训练pt2方式同理
# sh pt2_train.sh
nohup ./lora_train.sh > /tmp/train.log 2 > &1 &
会在当前目录创建一个output目录,最终模型输出到这里面
0%| | 7/3204 [00:17 < 2:08:32, 2.41s/it]
微调之后:
参数调整后,输出的路径可能会改变。可以去 fine-tuning-lab/chatglm3 目录里面的 output 目录下查看,里面是训练后的模型。
然后修改 chatglm3_lora.sh 里面的 CHECKPOINT_DIR,指向你想加载的训练后模型。
AutoDL服务器在国内,如果需要访问外网:
source /etc/network_turbo
checkpoint-nnn 是训练过程中的中间结果,nnn 数字最大的那个是最终结果
chatglm3/output/hotel_lora-20240728-124303# ls -ltrh
total 8.8M
drwxr-xr-x 2 root root 301 Jul 28 13:03 checkpoint-300
drwxr-xr-x 2 root root 301 Jul 28 13:23 checkpoint-600
drwxr-xr-x 2 root root 301 Jul 28 13:43 checkpoint-900
drwxr-xr-x 2 root root 301 Jul 28 14:03 checkpoint-1200
drwxr-xr-x 2 root root 301 Jul 28 14:23 checkpoint-1500
drwxr-xr-x 2 root root 301 Jul 28 14:43 checkpoint-1800
drwxr-xr-x 2 root root 301 Jul 28 15:04 checkpoint-2100
drwxr-xr-x 2 root root 301 Jul 28 15:24 checkpoint-2400
drwxr-xr-x 2 root root 301 Jul 28 15:44 checkpoint-2700
drwxr-xr-x 2 root root 301 Jul 28 16:04 checkpoint-3000
-rw-r--r-- 1 root root 460 Jul 28 16:12 tokenizer_config.json
-rw-r--r-- 1 root root 12K Jul 28 16:12 tokenization_chatglm.py
-rw-r--r-- 1 root root 3 Jul 28 16:12 special_tokens_map.json
-rw-r--r-- 1 root root 7.5M Jul 28 16:12 pytorch_model.bin
-rw-r--r-- 1 root root 4.9K Jul 28 16:12 training_args.bin
-rw-r--r-- 1 root root 4.2K Jul 28 16:12 trainer_state.json
-rw-r--r-- 1 root root 995K Jul 28 16:12 tokenizer.model
-rw-r--r-- 1 root root 300K Jul 28 16:20 train.log
drwxr-xr-x 2 root root 182 Jul 28 16:20 logs
/root/autodl-tmp/fine-tuning-lab/chatglm3/output/hotel_lora-20240728-124303/checkpoint-3000
/root/autodl-tmp/fine-tuning-lab/chatglm3/output/hotel_lora-20240728-124303/checkpoint-3000
# ls
optimizer.pt rng_state.pth special_tokens_map.json tokenizer.model trainer_state.json
pytorch_model.bin scheduler.pt tokenization_chatglm.py tokenizer_config.json training_args.bin
cp lora_eval.sh lora_eval2.sh
# cat lora_eval2.sh
#! /usr/bin/env bash
MODEL_DIR="/root/autodl-tmp/chatglm3-6b"
CHECKPOINT_DIR="/root/autodl-tmp/fine-tuning-lab/chatglm3/output/hotel_lora-20240728-124303/checkpoint-3000"
CUDA_VISIBLE_DEVICES=0 python cli_evaluate.py \
--test_file ../data/test.chatglm3.jsonl \
--model_name_or_path $MODEL_DIR \
--checkpoint_path $CHECKPOINT_DIR \
--lora_rank 8 \
--lora_alpha 32 \
--lora_dropout 0.1
chatglm3# ./lora_eval2.sh
Loading checkpoint shards: 0%| | 0/7 [00:00<?, ?it/s]/root/miniconda3/envs/agiclass/lib/python3.11/site-packages/torch/_utils.py:831: UserWarning: TypedStorage is deprecated. It will be removed in the future and UntypedStorage will be the only storage class. This should only matter to you if you are using storages directly. To access UntypedStorage directly, use tensor.untyped_storage() instead of tensor.storage()
return self.fget.__get__(instance, owner)()
Loading checkpoint shards: 100%|█████████████████████████████████████████████████████████████████████████████████████████████████████████| 7/7 [00:01<00:00, 4.47it/s]
100%|████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████████| 201/201 [09:13<00:00, 2.75s/it]
score dict: {'slot_P': 94.9097, 'slot_R': 92.926, 'slot_F1': 93.9074, 'bleu-4': 65.3169}
slot_P (Precision, 精确率):
精确率衡量的是模型预测为正类的样本中,真正为正类的样本所占的比例。在命名实体识别或类似的任务中,它表示模型预测出的所有命名实体中,真正属于命名实体的比例。高精确率意味着模型预测结果中,误报(将非命名实体预测为命名实体)的情况较少。
计算公式为:精确率 = 真正例(TP) / (真正例(TP) + 假正例(FP))
slot_R (Recall, 召回率):
召回率衡量的是在所有实际为正类的样本中,被模型正确预测为正类的样本所占的比例。在命名实体识别任务中,它表示在所有真实的命名实体中,模型成功识别出的命名实体的比例。高召回率意味着模型能够找到大多数真实的命名实体,但可能会以牺牲精确率为代价。
计算公式为:召回率 = 真正例(TP) / (真正例(TP) + 假负例(FN))
slot_F1 (F1 Score, F1分数):
F1分数是精确率和召回率的调和平均数,用于综合评估模型的性能。它是精确率和召回率的加权平均值,给予了两者相同的权重。F1分数越高,说明模型的性能越好,即模型在精确率和召回率之间取得了良好的平衡。
计算公式为:F1 = 2 * (精确率 * 召回率) / (精确率 + 召回率)
bleu-4 (BLEU Score, 4-gram Bilingual Evaluation Understudy):
BLEU分数是一种评估机器翻译文本质量的指标,
但也可以用于评估其他文本生成任务(如摘要、对话生成等)的输出质量。
BLEU分数通过计算生成文本与参考文本之间的n-gram(这里是4-gram)共现程度来评估文本的流畅度和准确性。
较高的BLEU分数表示生成文本与参考文本更相似,但需要注意的是,BLEU分数并不完美,它可能无法完全反映生成文本的质量,尤其是当参考文本有多个可能的正确翻译时。
BLEU分数的计算涉及多个步骤,包括计算n-gram的精确度、长度惩罚等。
总结来说,这些指标共同提供了模型在命名实体识别或文本生成任务中性能的全面评估。
高精确率、高召回率和高F1分数通常意味着模型在识别命名实体或生成文本方面表现良好,
而较高的BLEU分数则表明生成的文本与参考文本相似度较高。
mytab('ulglmrongqi', 'tbglmrongqi');
训练
GLM中gradient_accumulation_steps参数
训练脚本示例
GLM中gradient_accumulation_steps参数
在大模型GLM中,gradient_accumulation_steps参数是一个关键的训练参数,
它指的是在反向传播算法中,每隔多少个batch(或称为mini-batch)会更新一次模型的参数。
传统的反向传播算法会在每个batch更新一次参数,
但使用gradient_accumulation_steps参数可以将多个batch的梯度累积起来,再进行一次参数更新。
这一参数的设置对模型的训练过程有显著影响,主要体现在以下几个方面:
节省显存使用:
在GPU训练深度学习模型时,显存的容量是有限的。
当batch size较大时,一次性将所有的样本放入内存中可能会导致显存溢出。
通过梯度累积,可以将一个大的batch分成若干个小的mini-batch,在每个mini-batch上计算梯度并累积,
从而减少了一次性加载大batch所需的显存。这对于显存容量较小的设备来说尤为重要。
减小梯度更新的频率:在深度学习中,梯度更新的频率会影响模型的收敛速度和稳定性。
如果在每个batch都更新参数,可能会因为噪声导致模型收敛变慢或者发散。
而梯度累积可以将多个batch的梯度进行平均,从而减小变化的幅度,使得模型更加稳定。
处理样本不平衡问题:在一些实际应用中,数据集中的不同类别的样本数量可能存在很大的差异。
如果不平衡的样本在同一个mini-batch中,可能导致模型偏向于多数样本类别。
使用梯度累积的方法可以将不同mini-batch中的样本混合起来,从而更好地平衡不同类别的样本。
然而,gradient_accumulation_steps参数的选择也需要进行调优。
过小的gradient_accumulation_steps会导致梯度的更新频率过高,容易出现收敛不稳定的情况;
而过大的gradient_accumulation_steps则会导致梯度的更新频率过低,可能会增加模型的收敛时间。
因此,在实际应用中,需要根据具体的问题和硬件平台来选择合适的gradient_accumulation_steps参数值,
以达到更好的模型性能和收敛效果。
综上所述,gradient_accumulation_steps参数在大模型GLM的训练中扮演着重要的角色,
它通过累积多个batch的梯度来更新模型参数,从而节省显存使用、减小梯度更新的频率,
并有助于处理样本不平衡问题。
在大模型GLM中,gradient_accumulation_steps参数的具体设置值并不是一个固定的数字,而是需要根据具体的训练任务、硬件资源、数据集大小以及模型复杂度等多种因素来确定的。这个参数的主要作用是控制梯度累积的步数,即在多少个mini-batch的梯度计算完成后,进行一次模型参数的更新。
设置gradient_accumulation_steps的考虑因素:
硬件资源:
GPU显存:如果GPU显存有限,但希望使用较大的batch size来提高训练稳定性或加速训练过程,
可以通过增加gradient_accumulation_steps来实现。
这样可以将大batch分割成多个小mini-batch,逐步累积梯度,
从而在不增加显存负担的情况下模拟大batch的效果。
计算性能:虽然梯度累积可以减少显存使用,
但它也会增加训练的总步数(即需要处理更多的mini-batch),
这可能会增加总的训练时间。
因此,在设置时需要权衡计算性能和显存使用之间的平衡。
数据集大小:
数据集的总大小和每个mini-batch的大小将影响gradient_accumulation_steps的设置。
如果数据集很大,但每个mini-batch的大小较小,
那么可能需要设置较大的gradient_accumulation_steps来确保每次更新都使用了足够多的数据。
模型复杂度:
复杂的模型通常需要更多的数据来训练,
因此可能需要设置较大的gradient_accumulation_steps来确保每次更新都使用了足够的梯度信息。
训练稳定性和收敛速度:
较小的gradient_accumulation_steps值(即更频繁的参数更新)可能会导致模型收敛速度更快,
但也可能增加训练过程中的不稳定性。
相反,较大的值可以提高稳定性,但可能会减慢收敛速度。
示例和实际操作:
在实际操作中,通常会通过试验不同的gradient_accumulation_steps值来找到最优的设置。
这可以通过观察训练过程中的损失函数值、验证集上的性能指标以及训练时间等来进行评估。
例如,如果原始batch size为32,但由于显存限制无法直接设置,
可以将其减小为16或8,
并通过设置gradient_accumulation_steps=2或gradient_accumulation_steps=4
来模拟原始的batch size效果。
这样可以在不增加显存负担的情况下,保持或接近原有的训练稳定性和收敛速度。
结论:
因此,在大模型GLM中,gradient_accumulation_steps参数的具体设置值
是一个需要根据具体情况进行调优的超参数。
没有一个固定的值适用于所有情况,而是需要通过实验和评估来确定最优的设置。
#! /usr/bin/env bash
set -ex
LR=2e-4
MAX_SEQ_LEN=3072
DATESTR=`date +%Y%m%d-%H%M%S`
RUN_NAME=hotel_lora
OUTPUT_DIR=output/${RUN_NAME}-${DATESTR}
mkdir -p $OUTPUT_DIR
BASE_MODEL_PATH=/root/autodl-tmp/chatglm3-6b
CUDA_VISIBLE_DEVICES=0 python main_lora.py \
--do_train \
--do_eval \
--train_file ../data/train.chatglm3.jsonl \
--validation_file ../data/dev.chatglm3.jsonl \
--max_seq_length $MAX_SEQ_LEN \
--preprocessing_num_workers 1 \
--model_name_or_path $BASE_MODEL_PATH \
--output_dir $OUTPUT_DIR \
--per_device_train_batch_size 1 \
--gradient_accumulation_steps 2 \
--per_device_eval_batch_size 2 \
--num_train_epochs 4 \
--evaluation_strategy steps \
--eval_steps 300 \
--logging_steps 300 \
--logging_dir $OUTPUT_DIR/logs \
--save_steps 300 \
--learning_rate $LR \
--lora_rank 8 \
--lora_alpha 32 \
--lora_dropout 0.1 2>&1 | tee ${OUTPUT_DIR}/train.log
--per_device_train_batch_size 1 每个GPU上放一个批次
--gradient_accumulation_steps 2 每隔2个批次更新一次梯度
也就是说GPU的个数*per_device_train_batch_size*gradient_accumulation_steps
才是真正意义上的一个批次
mytab('ulglmtrain', 'tbglmtrain');
llama3微调
量化
训练
预测
使用peft进行量化
import json
import torch
from transformers import (
AutoTokenizer,
AutoModelForCausalLM,
BitsAndBytesConfig,
DataCollatorForSeq2Seq,
HfArgumentParser,
TrainingArguments,
Trainer
)
from peft import LoraConfig, TaskType, get_peft_model
from arguments import ModelArguments, DataTrainingArguments, PeftArguments
from data_preprocess import InputOutputDataset
def load_model(model_name):
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_use_double_quant=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=torch.float16,
)
n_gpus = torch.cuda.device_count()
model = AutoModelForCausalLM.from_pretrained(
model_name,
quantization_config=bnb_config,
device_map="auto", # dispatch efficiently the model on the available ressources
max_memory = {i: '24400MB' for i in range(n_gpus)},
)
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
return model, tokenizer
bnb_4bit_quant_type="nf4",
4bit量化,按4bit的格式加载模型
将LoRA的配置注入模型
model, tokenizer = load_model(model_args.model_name_or_path)
model = get_peft_model(model, lora_config)
#数据规整器
data_collator = DataCollatorForSeq2Seq(
tokenizer=tokenizer,
padding=True
)
#获取训练集与测试集
if training_args.do_train:
#定义训练器
trainer = Trainer(
model=model,
tokenizer=tokenizer,
data_collator=data_collator,
args=training_args,
train_dataset=train_dataset if training_args.do_train else None,
eval_dataset=eval_dataset if training_args.do_eval else None,
)
#训练
if training_args.do_train:
model.gradient_checkpointing_enable()
model.enable_input_require_grads()
trainer.train()
#预测
if training_args.do_eval:
trainer.evaluate()
# ./lora_eval.sh
Loading checkpoint shards: 100%|████████████████████████████████████████████████████████████████| 4/4 [00:07<00:00, 1.92s/it]
Special tokens have been added in the vocabulary, make sure the associated word embeddings are fine-tuned or trained.
100%|███████████████████████████████████████████████████████████████████████████████████████| 560/560 [22:18<00:00, 2.39s/it]
score dict: {'slot_P': 93.6378, 'slot_R': 92.283, 'slot_F1': 92.9555, 'bleu-4': 64.0666}
slot_P (Slot Precision, 槽位精确度)
slot_R (Slot Recall, 槽位召回率)
bleu:文本相似度
使用peft将训练好的checkpoint注入模型**
import json
import torch
import argparse
from tqdm import tqdm
from peft import PeftModel
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
from nltk.translate.bleu_score import sentence_bleu, SmoothingFunction
from data_preprocess import build_prompt, parse_json
def load_model(model_name, checkpoint):
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_use_double_quant=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=torch.float16,
)
n_gpus = torch.cuda.device_count()
model = AutoModelForCausalLM.from_pretrained(
model_name,
quantization_config=bnb_config,
device_map="auto",
max_memory = {i: '24500MB' for i in range(n_gpus)},
)
model = PeftModel.from_pretrained(model, model_id=checkpoint)
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
return model, tokenizer
template = build_prompt(item["context"])
input_ids = self.tokenizer.encode(template, add_special_tokens=False, return_tensors='pt').cuda()
outputs = self.model.generate(
input_ids=input_ids, max_new_tokens=1024,
eos_token_id=terminators,
pad_token_id=self.tokenizer.eos_token_id
)
outputs = outputs.tolist()[0][len(input_ids[0]):]
response = self.tokenizer.decode(outputs, skip_special_tokens=True)
|
|
|
|
|
LoRA原理详解
|
### 什么是LoRA
**LoRA (Low-Rank Adaptation,低秩适应)** 是一种参数高效的微调方法,由微软研究院于2021年提出。
#### 传统微调的问题
在大模型微调中,面临以下挑战:
- **参数量巨大**:GPT-3有1750亿参数,全量微调需要存储所有参数的副本
- **显存昂贵**:需要为每个任务存储完整的模型参数
- **存储成本高**:每个微调模型都需要数十GB的存储空间
#### LoRA的解决方案
LoRA的核心思想:**冻结预训练权重,通过训练低秩矩阵来适应新任务**
```
传统微调:W' = W + ΔW(需要存储完整的ΔW矩阵)
LoRA微调: W' = W + BA(只需存储小矩阵B和A)
```
#### 优势对比
| 特性 | 全量微调 | LoRA微调 |
|------|----------|----------|
| 可训练参数 | 100% | 0.1% - 3% |
| 显存占用 | 很高 | 很低 |
| 存储空间 | 完整模型 | 仅LoRA适配器 |
| 任务切换 | 需要加载完整模型 | 只需切换适配器 |
| 部署难度 | 高 | 低 |
#### 适用场景
- 多任务场景:需要为不同领域训练多个模型
- 资源受限:GPU显存不足以进行全量微调
- 快速迭代:频繁实验和调整模型
- 边缘部署:需要在有限资源的设备上运行
|
|
### LoRA核心思想
#### 低秩分解理论
LoRA基于一个重要的假设:**模型在适应特定任务时,参数变化的矩阵是低秩的**
这意味着虽然原始权重矩阵W很大(d×d),但需要更新的部分ΔW可以用两个小矩阵的乘积来近似:
```
ΔW = B × A
```
其中:
- W ∈ R^(d×d):原始权重矩阵(很大)
- B ∈ R^(d×r):降维投影矩阵
- A ∈ R^(r×d):升维投影矩阵
- r ≪ d:秩(rank),通常取8、16、32等
#### 为什么有效?
1. **降维-升维过程**
```
输入x (d维) → A投影到r维空间 → B投影回d维空间
```
2. **参数量对比**
```
全量微调参数:d × d
LoRA微调参数:d × r + r × d = 2 × d × r
当 r = 16, d = 4096:
全量:4096 × 4096 = 16,777,216
LoRA:2 × 4096 × 16 = 131,072
减少了:99.2%
```
3. **秩的选取**
- r = 8:极低参数量,适合简单任务
- r = 16:平衡选择,常用配置
- r = 32:更高精度,适合复杂任务
- r = 64+:接近全量微调效果
#### 视觉理解
想象一个高维空间(d维)中的变换:
- **原始权重W**:在这个空间中进行复杂变换
- **LoRA适配器**:只在一个低维子空间(r维)中调整
- **效果**:大部分微调效果可以通过低秩调整实现
#### 为什么冻结原始权重?
1. **保持预训练知识**:避免破坏模型已有的通用能力
2. **稳定训练**:减少训练不稳定性
3. **防止过拟合**:限制可训练参数数量
4. **便于切换**:可以轻松在不同任务适配器间切换
#### 重要辨析:LoRA到底省了什么?
这是一个常见的困惑点。让我们用一个具体例子说明:
```
假设原始权重 W 是 10×10 矩阵
传统微调:直接更新 W → 需要存储 100 个新参数
LoRA微调:W 冻结 + B(10×1) + A(1×10) → 只存储 20 个参数
最终结果:
W_merged = W + B×A → 仍然是一个 10×10 矩阵
```
**你的疑问是对的**:10×1 × 1×10 计算结果确实是 10×10,跟原来一样大。
#### 关键理解:省在哪?
LoRA节省的是 **训练阶段** 的资源,而不是推理阶段的计算:
| 方面 | 传统微调 | LoRA微调 | 节省原因 |
|------|----------|----------|----------|
| **训练时显存** | 存100个梯度 | 存20个梯度 | 可训练参数少 |
| **优化器状态** | 存100个动量等 | 存20个动量等 | Adam等优化器需要额外存储 |
| **存储空间** | 每任务存100参数 | 每任务存20参数 | 多任务场景优势明显 |
| **推理计算** | 1次矩阵乘法 | 1次矩阵乘法(合并后) | **没省**! |
| **推理显存** | 加载完整模型 | 加载完整模型 | **没省**! |
#### 具体数字说明
以7B模型为例,单个线性层 d=4096:
```
原始参数:4096 × 4096 = 16,777,216 个参数
训练时每层需要存储:
- 权重梯度:16,777,216(传统) vs 131,072(LoRA r=16)
- Adam动量:2 × 16,777,216(传统) vs 2 × 131,072(LoRA)
- 总计/层:~50MB(传统) vs ~0.4MB(LoRA)
全模型约80个线性层:
传统训练额外显存:~4GB
LoRA训练额外显存:~32MB
节省:99.2%
```
#### 推理阶段:计算没少
```
推理时的计算量:
原始:y = Wx (4096×4096 矩阵乘法)
LoRA合并后:y = (W+BA)x (同样是 4096×4096 矩阵乘法)
矩阵乘法次数:完全相同
计算延迟:完全相同
```
**结论**:推理阶段LoRA没有加速,甚至如果不合并还会更慢(因为要算两次)。
#### 那LoRA的价值在哪?
1. **训练省钱**:少存梯度 = 少用显存 = 可用更小GPU
2. **存储省钱**:100个任务只需存 100×20MB = 2GB,而非 100×16GB = 1.6TB
3. **切换方便**:一个基础模型 + 多个小适配器,随时切换任务
#### 形象比喻
```
传统微调 = 为每个任务买一整套新房子
LoRA微调 = 买了房子,每个任务只换不同的软装
住进去(推理)时:房子大小不变,生活空间不变
省钱的地方:不用每任务都买一整栋房子!
```
#### 什么时候LoRA没用?
如果只是训练一个模型然后固定使用,LoRA的收益不大。
LoRA真正发光的地方:**多任务、多租户、频繁切换**的场景。
|
|
### LoRA数学原理
#### 前向传播公式
在Transformer中,每个前馈层的计算为:
```
h = Wx + b
```
其中 W ∈ R^(d×k) 是权重矩阵,x ∈ R^k 是输入。
#### LoRA修改
LoRA将权重更新分解为低秩矩阵:
```
h = Wx + ΔWx
h = Wx + BAx
h = (W + BA)x
```
其中:
- W:预训练权重(冻结)
- B ∈ R^(d×r):降秩矩阵(初始为0)
- A ∈ R^(r×d):升秩矩阵(随机初始化)
- r:秩(r ≪ d, k)
#### 矩阵维度示意
```
原始权重 W: [d_out, d_in]
↓ ↓
B: [d_out, r] × A: [r, d_in]
↓
BA: [d_out, d_in] ≈ ΔW
```
#### 初始化策略
```python
# A使用随机初始化(Kaiming初始化)
A ~ Uniform(−1/√r, 1/√r) 或 A ~ N(0, σ²)
# B初始化为零,确保初始训练时ΔW = 0
B = 0
# 这样训练开始时,模型行为与预训练模型完全一致
```
为什么要这样初始化?
- **初始时刻**:BA = 0 × A = 0,模型保持预训练状态
- **训练开始**:B逐渐从0学习,A从随机值调整
- **训练结束**:BA学到适应新任务的更新量
#### 缩放因子α
实际实现中,LoRA引入缩放因子:
```
h = Wx + (α/r) × BAx
```
其中α是超参数(通常设为与r相同,如32、64)。
缩放因子的作用:
- **平衡LoRA贡献**:控制BA对原始模型的影响程度
- **调节学习率**:间接影响LoRA参数的更新幅度
- **稳定训练**:避免LoRA更新过大导致训练不稳定
#### 参数量计算
对于单个线性层:
| 项目 | 全量微调 | LoRA (r=16) | LoRA (r=32) |
|------|----------|-------------|-------------|
| 原始参数 | d × k | d × k | d × k |
| 可训练参数 | d × k | 2 × d × r | 2 × d × r |
| 参数占比 | 100% | 2r/k | 2r/k |
| d=4096,k=4096 | 16.8M | 131K (0.78%) | 262K (1.56%) |
对于整个模型(多个层),LoRA只需在每个目标层添加适配器。
|
|
### 训练与推理流程
#### 训练阶段
在训练阶段,模型结构如下:
```
输入 x
↓
├─→ [W 冻结] ──→ Wx ─┐
│ │
└─→ [A 可训练] → [B 可训练] → BAx ─┤
↓ → h = Wx + BAx
```
**关键点**:
1. W完全冻结,不参与梯度更新
2. A和B是可训练参数
3. 前向传播时同时计算两条路径
4. 损失反向传播只更新A和B
#### 推理阶段(合并权重)
训练完成后,可以将LoRA适配器合并到原始权重中:
```
W_merged = W + BA × (α/r)
```
推理时简化为:
```
输入 x
↓
[W_merged] → h = W_merged × x
```
**合并优势**:
- 无额外计算开销
- 无延迟增加
- 与原模型完全相同的推理速度
- 可以直接替换原模型使用
#### 推理阶段(不合并)
也可以保持适配器分离:
```
输入 x
↓
├─→ [W] ──→ Wx ─┐
│ │
└─→ [BA] → BAx ─┤
↓ → h = Wx + BAx
```
**不合并优势**:
- 可以动态切换不同任务的适配器
- 一个基础模型支持多个LoRA适配器
- 适合需要频繁切换任务的场景
#### 训练流程图
```
1. 初始化
└─→ 加载预训练模型 W
└─→ 初始化 A ~ N(0, σ²), B = 0
2. 前向传播
└─→ h = Wx + (α/r)BAx
3. 计算损失
└─→ Loss = L(h, y_true)
4. 反向传播
└─→ 只更新 A, B 的梯度
└─→ W 保持不变
5. 重复2-4直到收敛
```
#### 合并流程
```python
# 合并LoRA到原始权重
def merge_lora(W, A, B, alpha=1.0):
"""
W: 原始权重 [d_out, d_in]
A: LoRA矩阵A [r, d_in]
B: LoRA矩阵B [d_out, r]
alpha: 缩放因子
"""
r = A.shape[0]
lora_weight = (alpha / r) * (B @ A)
return W + lora_weight
```
#### 模型切换
```python
# 基础模型 + 多个LoRA适配器
base_model = load_model("llama-7b")
lora_coding = load_lora("lora-coding")
lora_chat = load_lora("lora-chat")
lora_math = load_lora("lora-math")
# 动态切换
def switch_task(task_name):
if task_name == "coding":
apply_lora(base_model, lora_coding)
elif task_name == "chat":
apply_lora(base_model, lora_chat)
elif task_name == "math":
apply_lora(base_model, lora_math)
```
|
|
### 代码实现
#### 基础LoRA实现
```python
import torch
import torch.nn as nn
import math
class LoRALayer(nn.Module):
"""LoRA适配器层"""
def __init__(self, in_features, out_features, rank=8, alpha=1.0):
super().__init__()
self.rank = rank
self.alpha = alpha
self.in_features = in_features
self.out_features = out_features
# LoRA矩阵 A: [rank, in_features]
self.lora_A = nn.Parameter(
torch.zeros(rank, in_features)
)
# LoRA矩阵 B: [out_features, rank]
self.lora_B = nn.Parameter(
torch.zeros(out_features, rank)
)
# 缩放因子
self.scaling = self.alpha / self.rank
# 初始化A(使用Kaiming初始化)
nn.init.kaiming_uniform_(self.lora_A, a=math.sqrt(5))
def forward(self, x):
# x: [batch_size, in_features]
# 计算 BAx
lora_out = x @ self.lora_A.T # [batch_size, rank]
lora_out = lora_out @ self.lora_B.T # [batch_size, out_features]
return self.scaling * lora_out
class LinearWithLoRA(nn.Module):
"""带LoRA的线性层"""
def __init__(self, in_features, out_features, rank=8, alpha=1.0):
super().__init__()
# 原始线性层(冻结)
self.linear = nn.Linear(in_features, out_features)
self.linear.weight.requires_grad = False
# LoRA适配器
self.lora = LoRALayer(in_features, out_features, rank, alpha)
def forward(self, x):
# 原始输出 + LoRA输出
return self.linear(x) + self.lora(x)
# 使用示例
layer = LinearWithLoRA(4096, 4096, rank=16, alpha=16)
x = torch.randn(2, 4096)
output = layer(x)
```
#### PEFT库使用
```python
from peft import LoraConfig, get_peft_model, TaskType
import torch
from transformers import AutoModelForCausalLM
# 加载基础模型
model = AutoModelForCausalLM.from_pretrained("llama-7b")
# 配置LoRA
peft_config = LoraConfig(
task_type=TaskType.CAUSAL_LM, # 任务类型
inference_mode=False, # 训练模式
r=16, # 秩
lora_alpha=32, # 缩放因子
lora_dropout=0.1, # Dropout率
target_modules=[ # 应用LoRA的模块
"q_proj", # Query投影
"k_proj", # Key投影
"v_proj", # Value投影
"o_proj", # Output投影
"gate_proj",
"up_proj",
"down_proj",
],
bias="none", # bias不参与LoRA
)
# 应用LoRA
model = get_peft_model(model, peft_config)
# 查看可训练参数
model.print_trainable_parameters()
# 输出示例:
# trainable params: 40,000,000 || all params: 6,700,000,000 || trainable%: 0.597
```
#### LoRA在QKV投影上的应用
```python
class AttentionWithLoRA(nn.Module):
"""自注意力层 + LoRA"""
def __init__(self, hidden_size, num_heads, rank=8):
super().__init__()
self.hidden_size = hidden_size
self.num_heads = num_heads
self.head_dim = hidden_size // num_heads
# 原始QKV投影(冻结)
self.qkv = nn.Linear(hidden_size, hidden_size * 3)
self.qkv.weight.requires_grad = False
# LoRA适配器
self.q_lora = LoRALayer(hidden_size, hidden_size, rank)
self.k_lora = LoRALayer(hidden_size, hidden_size, rank)
self.v_lora = LoRALayer(hidden_size, hidden_size, rank)
def forward(self, x):
batch_size, seq_len, _ = x.shape
# 原始QKV
qkv = self.qkv(x).reshape(batch_size, seq_len, 3, self.num_heads, self.head_dim)
q, k, v = qkv.unbind(2)
# 添加LoRA
q = q + self.q_lora(x).view(batch_size, seq_len, self.num_heads, self.head_dim)
k = k + self.k_lora(x).view(batch_size, seq_len, self.num_heads, self.head_dim)
v = v + self.v_lora(x).view(batch_size, seq_len, self.num_heads, self.head_dim)
return q, k, v
```
#### 完整训练示例
```python
from transformers import Trainer, TrainingArguments
# 配置训练器
trainer = Trainer(
model=model,
train_dataset=train_dataset,
args=TrainingArguments(
output_dir="./lora-output",
per_device_train_batch_size=4,
gradient_accumulation_steps=4,
learning_rate=2e-4,
num_train_epochs=3,
logging_steps=10,
save_steps=100,
fp16=True,
),
)
# 开始训练
trainer.train()
# 保存LoRA适配器
model.save_pretrained("./lora-adapter")
```
#### 加载并合并LoRA
```python
from peft import PeftModel
# 加载基础模型
base_model = AutoModelForCausalLM.from_pretrained("llama-7b")
# 加载LoRA适配器
model = PeftModel.from_pretrained(base_model, "./lora-adapter")
# 合并权重
merged_model = model.merge_and_unload()
# 保存合并后的模型
merged_model.save_pretrained("./merged-model")
```
|
|
### LoRA参数配置指南
#### 核心参数
##### 1. rank (r) - 秩
```python
r = 8 # 极低参数量,适合简单任务
r = 16 # 平衡选择,最常用
r = 32 # 高精度,适合复杂任务
r = 64 # 接近全量微调效果
```
**选择建议**:
- 任务复杂度高 → 用更大的r
- 数据量少 → 用较小的r避免过拟合
- 显存充足 → 可以尝试更大的r
##### 2. lora_alpha (α) - 缩放因子
```python
lora_alpha = 16 # 常与r相同
lora_alpha = 32 # 或设置为r的2倍
```
**作用**:控制BA对原始模型的影响程度
**经验公式**:
```python
lora_alpha = 2 * r # 常用配置
# 或
lora_alpha = r # 保守选择
```
##### 3. lora_dropout - Dropout率
```python
lora_dropout = 0.05 # 轻微正则化
lora_dropout = 0.1 # 标准正则化
lora_dropout = 0.0 # 不使用dropout
```
##### 4. target_modules - 应用LoRA的位置
```python
# 只在注意力层
target_modules = ["q_proj", "k_proj", "v_proj", "o_proj"]
# 只在FFN层
target_modules = ["gate_proj", "up_proj", "down_proj"]
# 全部线性层
target_modules = ["all-linear"]
# 自定义选择
target_modules = ["q_proj", "v_proj", "up_proj", "down_proj"]
```
**不同选择的效果**:
| 配置 | 可训练参数 | 效果 | 速度 |
|------|------------|------|------|
| 只QKV | 0.3% | 基础提升 | 最快 |
| QKV+FFN | 1% | 显著提升 | 中等 |
| 全线性 | 2-3% | 最佳效果 | 较慢 |
#### 常用配置模板
##### 配置1:快速实验(资源受限)
```python
lora_config = LoraConfig(
r=8,
lora_alpha=16,
lora_dropout=0.05,
target_modules=["q_proj", "v_proj"],
bias="none",
)
```
##### 配置2:标准训练(推荐)
```python
lora_config = LoraConfig(
r=16,
lora_alpha=32,
lora_dropout=0.1,
target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],
bias="none",
)
```
##### 配置3:最佳效果(充足资源)
```python
lora_config = LoraConfig(
r=32,
lora_alpha=64,
lora_dropout=0.1,
target_modules=["all-linear"],
bias="none",
)
```
#### 训练超参数配合
```python
training_args = TrainingArguments(
# 学习率需要与LoRA参数配合
learning_rate=2e-4, # LoRA通常用较高学习率
# 批次大小
per_device_train_batch_size=4,
gradient_accumulation_steps=4,
# 优化器
optim="adamw_torch"或"adamw_8bit", # 8bit节省显存
# 调度器
lr_scheduler_type="cosine", # 余弦退火
warmup_ratio=0.03, # 预热比例
# 精度
fp16=True, # 或bf16=True(新GPU)
# bf16=True, # 更稳定(A100/H100)
)
```
#### 显存估算
```
基础模型(7B, fp16): ~14GB
训练开销(optimizer等): ~2-4GB
LoRA参数(r=16): ~0.1GB
梯度缓存: ~2GB
─────────────────────────────
总显存需求: ~18-20GB
使用gradient_checkpointing可节省约4-6GB
```
#### 调试技巧
```python
# 1. 检查可训练参数
model.print_trainable_parameters()
# 2. 检查LoRA是否应用
for name, param in model.named_parameters():
if "lora" in name:
print(f"{name}: trainable={param.requires_grad}")
# 3. 监控梯度
if param.grad is not None:
print(f"Grad norm: {param.grad.norm()}")
# 4. 验证原始权重是否冻结
for name, param in model.named_parameters():
if "lora" not in name:
assert not param.requires_grad, f"{name} should be frozen!"
```
|
|
好的,以下是前两个问题核心内容的汇总整理表格,涵盖数学原理、显存占用拆解及实操瓶颈:
| 对比维度 | 具体内容 / 数学原理 | 显存占用与结论 |
| :--- | :--- | :--- |
| **核心误解澄清(形状 vs 参数量)** | 矩阵乘法结果 `BA` 的**输出形状**为 \( d \times k \),与 \( W \) 一致(所以能相加)。
但 `BA` 本身的**可训练参数量**为 \( d \times r + r \times k \)。 因秩 \( r \ll d, k \)(如 r=8, d=k=4096),参数量仅为 \( W \) 的 **0.39%**。 | 存储的是因子(B和A),而非乘积结果(BA)。 **显存并未翻倍**,持久占用的增量极小(约增加 0.5MB/层)。 | | **临时张量(峰值显存)** | 计算前向传播的 `W + BA` 时,必须瞬间构建一个完整的 \( d \times k \) 临时矩阵用于加法运算。 | **会瞬间产生峰值尖刺**(与 \( W \) 同等大小),但计算完成后立即释放,不常驻显存。 峰值压力仍存在,可能导致短暂 OOM。 | | **持久显存占用(单层对比)** | **全量微调**:需存储 \( W \)(权重)+ 梯度 + Adam 动量/方差。 **LoRA 微调**:\( W \) 冻结(仅前向,无梯度/优化器),仅额外存储小矩阵 \( A, B \) 及其梯度和优化器状态。 | 单层 FP16 对比: • 全量微调:~**64 MB** • LoRA 微调:~**16.5 MB** (显存降至约 1/4,节省主要来自优化器状态) | | **纯推理 vs LoRA 微调** | **推理**:只做前向传播,激活值(中间结果)用完即丢弃。 **微调**:反向传播依赖前向的激活值计算梯度,**所有激活值必须常驻显存**直到反向结束。 | **刚刚够推理的显存绝对跑不了微调**。 7B 模型(FP16)估算: • 纯推理:~**16 GB**(权重14G + 临时激活2G) • LoRA微调:~**26.5 GB**(权重14G + 常驻激活12G + 优化器0.5G) • 全量微调:~**54 GB** | | **显存不足的补救措施** | 针对激活值占用过大的“省显存”技巧: 1. **梯度检查点**:不存所有激活值,反向时重算(时间换空间)。 2. **ZeRO-Offload**:将优化器状态卸载至 CPU 内存。 3. 降低 **Batch Size** 和**序列长度**。 | 启用梯度检查点后,可将激活值显存从 12GB 压缩至 **~3GB**,使 24GB 显存(如 4090)能勉强跑起 7B 模型的 LoRA。 | **一句话总结**:LoRA 仅让“可训练参数”和“优化器状态”剧减(不翻倍),但**微调永远比推理多吃显存**(源于常驻激活值),且存在计算 `BA` 时的显存尖峰。若显存仅够推理,必须开启梯度检查点等优化手段才能尝试微调。 |
|
|
DeepSeek OCR2微调
|
### 环境安装
Unsloth是一个用于加速大模型微调的框架,支持多种视觉语言模型的训练。
#### 安装依赖
```python
%%capture
import os, re
if "COLAB_" not in "".join(os.environ.keys()):
!pip install unsloth # 本地和云端环境
else:
import torch
v = re.match(r'[\d]{1,}\.[\d]{1,}', str(torch.__version__)).group(0)
xformers = 'xformers==' + {'2.10':'0.0.34','2.9':'0.0.33.post1','2.8':'0.0.32.post2'}.get(v, "0.0.34")
!pip install sentencepiece protobuf "datasets==4.3.0" "huggingface_hub>=0.34.0" hf_transfer
!pip install --no-deps unsloth_zoo bitsandbytes accelerate {xformers} peft trl triton unsloth
!pip install --no-deps --upgrade "torchao>=0.16.0"
!pip install transformers==4.56.2
!pip install --no-deps trl==0.22.2
!pip install jiwer
!pip install einops addict easydict
```
#### 主要依赖说明
- `unsloth`: 核心微调框架,支持4bit量化和LoRA
- `transformers`: Hugging Face模型库
- `peft`: 参数高效微调库
- `trl`: 强化学习训练库
- `datasets`: 数据集处理库
- `jiwer`: 字符错误率评估库
|
|
### 模型加载
#### 下载DeepSeek OCR2模型
```python
from huggingface_hub import snapshot_download
snapshot_download("unsloth/DeepSeek-OCR-2", local_dir = "deepseek_ocr2")
```
#### 加载模型
```python
from unsloth import FastVisionModel
import torch
from transformers import AutoModel
import os
# 禁用未初始化警告
os.environ["UNSLOTH_WARN_UNINITIALIZED"] = '0'
# 支持4bit量化的模型列表
fourbit_models = [
"unsloth/Qwen3-VL-8B-Instruct-bnb-4bit",
"unsloth/Qwen3-VL-8B-Thinking-bnb-4bit",
]
model, tokenizer = FastVisionModel.from_pretrained(
"./deepseek_ocr2",
load_in_4bit = False, # False使用16bit LoRA,True使用4bit
auto_model = AutoModel,
trust_remote_code = True,
unsloth_force_compile = True,
use_gradient_checkpointing = "unsloth", # 长上下文时启用
)
```
#### 参数说明
- `load_in_4bit`: 是否使用4bit量化,可降低显存使用
- `trust_remote_code`: 是否信任远程代码
- `unsloth_force_compile`: 强制编译以提升性能
- `use_gradient_checkpointing`: 梯度检查点,节省显存
#### 不同配置对应参数
| 配置 | base_size | image_size | crop_mode |
|------|-----------|------------|-----------|
| Tiny | 512 | 512 | False |
| Small | 768 | 768 | False |
| Base | 1024 | 1024 | False |
| Large | 1280 | 1280 | False |
| Gundam | 1024 | 768 | True |
|
|
### 基线评估
在使用Unsloth微调之前,我们先评估DeepSeek OCR2的基线性能。
#### 加载测试数据集
```python
from datasets import load_dataset
dataset = load_dataset("hezarai/parsynth-ocr-200k", split = "train[:2000]")
```
#### 保存测试图片
```python
# 保存一张不在训练集的图片用于评估
dataset[1523]['image_path'].save("your_image.jpg")
```
#### 运行基线推理
```python
prompt = "<image>\nFree OCR. "
image_file = 'your_image.jpg'
output_path = 'your/output/dir'
res = model.infer(
tokenizer,
prompt = prompt,
image_file = image_file,
output_path = output_path,
base_size = 1024,
image_size = 768,
crop_mode = True,
save_results = True,
test_compress = False
)
```
#### 基线性能结果
**真实标签**:
```text
انضباطمم شدم حقیقتن باورم نمیشد
```
**基线模型输出**(CER = 23%):
```text
حفظ السلام
```
这个结果明显错误,字符错误率高达23%,需要通过微调来提升。
|
|
### LoRA配置
添加LoRA适配器进行参数高效微调,只需训练1%的参数即可获得良好效果。
#### 配置LoRA参数
```python
model = FastVisionModel.get_peft_model(
model,
target_modules = [
"q_proj", # Query投影
"k_proj", # Key投影
"v_proj", # Value投影
"o_proj", # Output投影
"gate_proj", # Gate投影
"up_proj", # Up投影
"down_proj", # Down投影
],
r = 16, # 秩,越大越准确但可能过拟合
lora_alpha = 16, # 缩放因子,建议与r相同
lora_dropout = 0, # Dropout率
bias = "none", # Bias设置
random_state = 3407,
use_rslora = False, # 是否使用Rank Stabilized LoRA
loftq_config = None, # 是否使用LoftQ初始化
)
```
#### 参数说明
- `target_modules`: 要应用LoRA的模块,可以选择:
- 只微调视觉部分
- 只微调语言部分
- 同时微调两者
- 选择注意力或MLP层
- `r`: LoRA秩,控制适配器大小
- 较大的r:更高的精度,但可能过拟合
- 较小的r:更少的参数,更快训练
- `lora_alpha`: LoRA缩放因子
- 通常设置为与r相同或更大
- 控制LoRA对原模型的影响程度
- `lora_dropout`: Dropout率,防止过拟合
#### 为什么这里 lora_dropout = 0?
在DeepSeek OCR2的配置中,`lora_dropout = 0`,这与常见的LoRA配置(通常设置为0.05-0.1)不同。原因如下:
**1. 数据集规模小**
```python
dataset = load_dataset("hezarai/parsynth-ocr-200k", split = "train[:1000]")
# 只用了1000个样本
```
- 数据量小,模型本来就难以充分学习
- 此时的正则化(dropout)可能导致欠拟合
**2. 视觉任务的特点**
OCR任务是**确定性的映射**:
- 输入:固定图像
- 输出:固定文本
- 不像NLP生成任务有多个合理答案
```
图像 "hello" → 文本 "hello" (唯一正确答案)
对话 "你好" → 回答 "您好"/"你好"/"嗨"(多个合理答案)
```
确定性任务不需要dropout增加"随机性"。
**3. LoRA本身就有正则化效果**
LoRA的**低秩约束**本身就是一种正则化:
```
全量微调:可训练 d×d 个参数(自由度极高)
LoRA微调:只训练 2×d×r 个参数(r≪d,自由度受限)
```
这种参数量的限制已经起到防止过拟合的作用。
**4. 训练步数少**
```python
max_steps = 60 # 只有60步
```
- 训练步数少,过拟合风险本来就低
- dropout在短训练中可能来不及发挥作用
**5. 预训练模型已经很强**
DeepSeek OCR2是强大的预训练模型:
- 已经学会通用的OCR能力
- 微调只是让它适应特定语言(波斯语)
- 任务相对简单,不需要强正则化
#### 什么时候应该用dropout?
| 场景 | dropout设置 | 原因 |
|------|--------------|------|
| 小数据集+少步数 | 0 或很小 | 防止欠拟合 |
| 大数据集+多步数 | 0.05-0.1 | 防止过拟合 |
| 生成任务 | 0.1 | 增加多样性 |
| 分类/OCR任务 | 0 或很小 | 任务确定性高 |
| 参数量少(r小) | 0 | 低秩已足够正则化 |
| 参数量多(r大) | 0.05+ | 需要额外正则化 |
#### 不同场景的dropout配置示例
```python
# 场景1:小数据集OCR(如本例)
lora_config = LoraConfig(
r=16,
lora_alpha=16,
lora_dropout=0, # 不使用dropout
)
# 场景2:大规模文本生成
lora_config = LoraConfig(
r=32,
lora_alpha=64,
lora_dropout=0.1, # 标准dropout
)
# 场景3:非常小的数据集(<500样本)
lora_config = LoraConfig(
r=8,
lora_alpha=16,
lora_dropout=0, # 不用dropout,避免欠拟合
)
# 场景4:大型数据集(>100K样本)
lora_config = LoraConfig(
r=64,
lora_alpha=128,
lora_dropout=0.05, # 轻微dropout
)
```
#### 总结
在DeepSeek OCR2微调中设置`lora_dropout=0`是因为:
1. **数据量小**:1000样本,需要充分利用
2. **训练短**:60步,来不及充分发挥dropout作用
3. **任务确定**:OCR是确定性映射
4. **低秩已够**:r=16的低秩约束已提供足够正则化
|
|
### 数据准备
#### 数据格式
视觉微调任务的数据格式如下:
```python
[
{
"role": "<|User|>",
"content": "",
"images": []
},
{
"role": "<|Assistant|>",
"content": ""
},
]
```
#### 数据转换函数
- 以对话的格式:一问一答的方式,把图片和文本送给大模型学习
```python
instruction = "<image>\nFree OCR. "
def convert_to_conversation(sample):
"""将数据集样本转换为对话格式"""
conversation = [
{
"role": "<|User|>",
"content": instruction,
"images": [sample['image']]
},
{
"role": "<|Assistant|>",
"content": sample["text"]
},
]
return {"messages": conversation}
# 加载数据集
dataset = load_dataset("hezarai/parsynth-ocr-200k", split = "train[:1000]")
dataset = dataset.rename_column("image_path", "image")
# 转换数据集
converted_dataset = [convert_to_conversation(sample) for sample in dataset]
```
#### 转换后的数据示例
```python
converted_dataset[0]
# 输出:
# {'messages': [
# {'role': '<|User|>', 'content': '<image>\nFree OCR. ', 'images': [<PIL Image>]},
# {'role': '<|Assistant|>', 'content': 'همهاش جبره و اختیار توهمه'}
# ]}
```
|
|
### 数据整理器(Data Collator)
DeepSeek OCR2使用自定义的数据整理器来处理图像和文本的联合输入。
#### Data Collator类定义
```python
import torch
import math
from dataclasses import dataclass
from typing import Dict, List, Any, Tuple
from PIL import Image, ImageOps
from torch.nn.utils.rnn import pad_sequence
import io
from deepseek_ocr2.modeling_deepseekocr2 import (
format_messages,
text_encode,
BasicImageTransform,
dynamic_preprocess,
)
@dataclass
class DeepSeekOCR2DataCollator:
"""DeepSeek OCR2数据整理器
参数:
tokenizer: 分词器
model: 模型
image_size: 图像补丁大小(默认: 768)
base_size: 全局视图大小(默认: 1024)
crop_mode: 是否对大图像使用动态裁剪
train_on_responses_only: 是否只在助手回复上训练
"""
tokenizer: Any
model: Any
image_size: int = 768
base_size: int = 1024
crop_mode: bool = True
image_token_id: int = 128815
train_on_responses_only: bool = True
```
#### 图像处理流程
1. **图像反序列化**:将字节或PIL图像转换为RGB格式
2. **图像预处理**:根据crop_mode决定是否裁剪
3. **Token计算**:计算图像将生成的token数量
4. **批量处理**:将多个样本打包成一个批次
#### 核心方法
- `deserialize_image()`: 转换图像格式
- `calculate_image_token_count()`: 计算图像token数
- `process_image()`: 处理单张图像
- `process_single_sample()`: 处理单个对话样本
- `__call__()`: 整理批次数据
|
|
### 训练模型
#### 配置训练器
```python
from transformers import Trainer, TrainingArguments
from unsloth import is_bf16_supported
# 启用训练模式
FastVisionModel.for_training(model)
# 创建数据整理器
data_collator = DeepSeekOCR2DataCollator(
tokenizer = tokenizer,
model = model,
image_size = 768,
base_size = 1024,
crop_mode = True,
train_on_responses_only = True,
)
# 配置训练器
trainer = Trainer(
model = model,
tokenizer = tokenizer,
data_collator = data_collator,
train_dataset = converted_dataset,
args = TrainingArguments(
per_device_train_batch_size = 2,
gradient_accumulation_steps = 4,
warmup_steps = 5,
max_steps = 60, # 完整训练可设置 num_train_epochs = 1
learning_rate = 2e-4,
logging_steps = 1,
optim = "adamw_8bit",
weight_decay = 0.001,
lr_scheduler_type = "linear",
seed = 3407,
fp16 = not is_bf16_supported(),
bf16 = is_bf16_supported(),
output_dir = "outputs",
report_to = "none",
dataloader_num_workers = 2,
# 视觉微调必须设置
remove_unused_columns = False,
),
)
```
#### 训练参数说明
- `per_device_train_batch_size`: 每设备批次大小
- `gradient_accumulation_steps`: 梯度累积步数
- `max_steps`: 最大训练步数
- `learning_rate`: 学习率
- `warmup_steps`: 预热步数
- `remove_unused_columns`: 保留图像列(视觉任务必须)
#### 开始训练
```python
# 查看GPU状态
gpu_stats = torch.cuda.get_device_properties(0)
print(f"GPU = {gpu_stats.name}. Max memory = {round(gpu_stats.total_memory / 1024**3)} GB.")
# 开始训练
trainer_stats = trainer.train()
# 查看训练统计
print(f"{round(trainer_stats.metrics['train_runtime'] / 60, 2)} minutes used for training.")
print(f"Peak reserved memory = {round(torch.cuda.max_memory_reserved() / 1024**3, 3)} GB.")
```
#### 训练输出示例
```text
Trainable parameters = 86,307,840 of 3,475,427,200 (2.48% trained)
744.5682 seconds used for training.
12.41 minutes used for training.
Peak reserved memory = 8.367 GB.
Peak reserved memory for training = 1.529 GB.
```
|
|
### 推理验证
#### 微调后推理
```python
# 启用推理模式
FastVisionModel.for_inference(model)
prompt = "<image>\nFree OCR. "
image_file = 'your_image.jpg'
output_path = 'your/output/dir'
res = model.infer(
tokenizer,
prompt = prompt,
image_file = image_file,
output_path = output_path,
image_size = 768,
base_size = 1024,
crop_mode = True,
save_results = True,
test_compress = False
)
```
#### 性能对比
| 类型 | OCR输出 | CER |
|------|---------|-----|
| 基线(微调前) | `حفظ السلام` | 23% |
| 微调后(60步) | `انضباطم شدم حقیقتن باورم نمیشه` | 6% |
| 真实标签 | `انضباطمم شدم حقیقتن باورم نمیشد` | - |
仅用60步训练,字符错误率从23%降至6%,相对改善了74%!
#### 保存模型
```python
# 保存LoRA适配器
model.save_pretrained("deepseek_ocr_lora")
tokenizer.save_pretrained("deepseek_ocr_lora")
# 保存为16bit合并模型
if False:
model.save_pretrained_merged("unsloth_finetune", tokenizer)
# 推送到Hugging Face
if False:
model.push_to_hub_merged("YOUR_USERNAME/unsloth_finetune", tokenizer, token = "YOUR_HF_TOKEN")
```
#### 加载微调模型
```python
from unsloth import FastVisionModel
model, tokenizer = FastVisionModel.from_pretrained(
model_name = "deepseek_ocr_lora",
load_in_4bit = False,
auto_model = AutoModel,
trust_remote_code = True,
unsloth_force_compile = True,
use_gradient_checkpointing = "unsloth",
)
FastVisionModel.for_inference(model)
```
|
|
### 完整代码
#### 环境安装
```python
%%capture
import os, re
if "COLAB_" not in "".join(os.environ.keys()):
!pip install unsloth
else:
import torch
v = re.match(r'[\d]{1,}.[\d]{1,}', str(torch.__version__)).group(0)
xformers = 'xformers==' + {'2.10':'0.0.34','2.9':'0.0.33.post1','2.8':'0.0.32.post2'}.get(v, "0.0.34")
!pip install sentencepiece protobuf "datasets==4.3.0" "huggingface_hub>=0.34.0" hf_transfer
!pip install --no-deps unsloth_zoo bitsandbytes accelerate {xformers} peft trl triton unsloth
!pip install --no-deps --upgrade "torchao>=0.16.0"
!pip install transformers==4.56.2
!pip install --no-deps trl==0.22.2
!pip install jiwer
!pip install einops addict easydict
```
#### 模型加载
```python
from huggingface_hub import snapshot_download
snapshot_download("unsloth/DeepSeek-OCR-2", local_dir = "deepseek_ocr2")
from unsloth import FastVisionModel
import torch
from transformers import AutoModel
import os
os.environ["UNSLOTH_WARN_UNINITIALIZED"] = '0'
model, tokenizer = FastVisionModel.from_pretrained(
"./deepseek_ocr2",
load_in_4bit = False,
auto_model = AutoModel,
trust_remote_code = True,
unsloth_force_compile = True,
use_gradient_checkpointing = "unsloth",
)
```
#### 基线评估
```python
from datasets import load_dataset
dataset = load_dataset("hezarai/parsynth-ocr-200k", split = "train[:2000]")
dataset[1523]['image_path'].save("your_image.jpg")
prompt = "<image>\nFree OCR. "
res = model.infer(tokenizer, prompt = prompt, image_file = 'your_image.jpg',
output_path = 'output', base_size = 1024, image_size = 768,
crop_mode = True, save_results = True)
```
#### LoRA配置
```python
model = FastVisionModel.get_peft_model(
model,
target_modules = ["q_proj", "k_proj", "v_proj", "o_proj",
"gate_proj", "up_proj", "down_proj"],
r = 16,
lora_alpha = 16,
lora_dropout = 0,
bias = "none",
random_state = 3407,
)
```
#### 数据准备
```python
instruction = "<image>\nFree OCR. "
def convert_to_conversation(sample):
conversation = [
{"role": "<|User|>", "content": instruction, "images": [sample['image']]},
{"role": "<|Assistant|>", "content": sample["text"]},
]
return {"messages": conversation}
dataset = load_dataset("hezarai/parsynth-ocr-200k", split = "train[:1000]")
dataset = dataset.rename_column("image_path", "image")
converted_dataset = [convert_to_conversation(sample) for sample in dataset]
```
#### Data Collator
```python
@dataclass
class DeepSeekOCR2DataCollator:
tokenizer: Any
model: Any
image_size: int = 768
base_size: int = 1024
crop_mode: bool = True
train_on_responses_only: bool = True
def __call__(self, features: List[Dict]) -> Dict[str, torch.Tensor]:
# 处理批次数据
batch_data = [self.process_single_sample(f['messages']) for f in features]
# 填充序列、创建标签、注意力掩码
# 返回训练所需的张量字典
pass
```
#### 训练
```python
from transformers import Trainer, TrainingArguments
FastVisionModel.for_training(model)
data_collator = DeepSeekOCR2DataCollator(
tokenizer, model, image_size=768, base_size=1024,
crop_mode=True, train_on_responses_only=True
)
trainer = Trainer(
model = model,
tokenizer = tokenizer,
data_collator = data_collator,
train_dataset = converted_dataset,
args = TrainingArguments(
per_device_train_batch_size = 2,
gradient_accumulation_steps = 4,
max_steps = 60,
learning_rate = 2e-4,
fp16 = not is_bf16_supported(),
bf16 = is_bf16_supported(),
output_dir = "outputs",
remove_unused_columns = False,
),
)
trainer.train()
```
#### 推理与保存
```python
# 推理
FastVisionModel.for_inference(model)
res = model.infer(tokenizer, prompt="<image>\nFree OCR. ",
image_file='your_image.jpg', output_path='output',
image_size=768, base_size=1024, crop_mode=True)
# 保存
model.save_pretrained("deepseek_ocr_lora")
tokenizer.save_pretrained("deepseek_ocr_lora")
```
|
Qwen3 VL微调
|
### 环境安装
Qwen3-VL是阿里巴巴推出的多模态视觉语言模型,支持图像理解和LaTeX公式识别等任务。
#### 安装依赖
```python
%%capture
import os, re
if "COLAB_" not in "".join(os.environ.keys()):
!pip install unsloth # 本地和云端环境
else:
import torch
v = re.match(r'[\d]{1,}.[\d]{1,}', str(torch.__version__)).group(0)
xformers = 'xformers==' + {'2.10':'0.0.34','2.9':'0.0.33.post1','2.8':'0.0.32.post2'}.get(v, "0.0.34")
!pip install sentencepiece protobuf "datasets==4.3.0" "huggingface_hub>=0.34.0" hf_transfer
!pip install --no-deps unsloth_zoo bitsandbytes accelerate {xformers} peft trl triton unsloth
!pip install --no-deps --upgrade "torchao>=0.16.0"
!pip install transformers==4.57.1
!pip install --no-deps trl==0.22.2
```
#### 支持的视觉模型
Unsloth支持多种4bit量化视觉模型:
```python
fourbit_models = [
"unsloth/Llama-3.2-11B-Vision-Instruct-bnb-4bit", # Llama 3.2视觉
"unsloth/Llama-3.2-90B-Vision-Instruct-bnb-4bit", # 90B版本
"unsloth/Pixtral-12B-2409-bnb-4bit", # Pixtral系列
"unsloth/Pixtral-12B-Base-2409-bnb-4bit",
"unsloth/Qwen2-VL-2B-Instruct-bnb-4bit", # Qwen2 VL
"unsloth/Qwen2-VL-7B-Instruct-bnb-4bit",
"unsloth/llava-v1.6-mistral-7b-hf-bnb-4bit", # LLaVA系列
"unsloth/llava-1.5-7b-hf-bnb-4bit",
]
```
#### 主要特性
- **4bit量化**:大幅降低显存占用
- **梯度检查点**:支持长上下文训练
- **模块化微调**:可单独微调视觉或语言部分
- **快速训练**:Unsloth优化,训练速度提升2x
|
|
### 模型加载
#### 加载Qwen3-VL模型
```python
from unsloth import FastVisionModel
import torch
model, tokenizer = FastVisionModel.from_pretrained(
"unsloth/Qwen3-VL-8B-Instruct-unsloth-bnb-4bit",
load_in_4bit = True, # 使用4bit量化节省显存
use_gradient_checkpointing = "unsloth", # 长上下文时启用
)
```
#### 参数说明
- `load_in_4bit`:
- `True`: 使用4bit量化,显存占用~8GB
- `False`: 使用16bit,显存占用~16GB
- `use_gradient_checkpointing`:
- `True`: 标准梯度检查点
- `"unsloth"`: Unsloth优化的梯度检查点(更快)
#### 模型架构
```
Qwen3-VL-8B包含:
├── 视觉编码器 (Vision Encoder)
│ └── 处理输入图像,提取视觉特征
├── 视觉-语言投影层 (VL Projector)
│ └── 将视觉特征投影到语言空间
└── 语言模型 (Qwen2.5-7B)
└── 处理文本输入,生成输出
```
#### 内存需求
| 配置 | 显存占用 | 推荐场景 |
|------|----------|----------|
| 4bit量化 | ~8GB | Colab T4/V100 |
| 16bit | ~16GB | A100/V100 16GB+ |
| 梯度检查点 | 节省2-4GB | 长上下文任务 |
|
|
### LoRA配置
Qwen3-VL支持细粒度的模块选择,可以单独控制视觉层、语言层、注意力层和MLP层。
#### 配置LoRA参数
```python
model = FastVisionModel.get_peft_model(
model,
# 模块化微调控制
finetune_vision_layers = True, # 是否微调视觉层
finetune_language_layers = True, # 是否微调语言层
finetune_attention_modules = True, # 是否微调注意力模块
finetune_mlp_modules = True, # 是否微调MLP模块
# LoRA参数
r = 16, # 秩,越大精度越高但可能过拟合
lora_alpha = 16, # 缩放因子,建议与r相同
lora_dropout = 0, # Dropout率
bias = "none", # bias设置
random_state = 3407,
use_rslora = False, # 是否使用Rank Stabilized LoRA
loftq_config = None, # 是否使用LoftQ初始化
)
```
#### 模块化微调策略
不同任务可以采用不同的微调策略:
```python
# 策略1: 只微调视觉层(适用于视觉特征迁移)
vision_only = FastVisionModel.get_peft_model(
model,
finetune_vision_layers = True,
finetune_language_layers = False,
finetune_attention_modules = False,
finetune_mlp_modules = False,
)
# 策略2: 只微调语言层(适用于格式调整)
language_only = FastVisionModel.get_peft_model(
model,
finetune_vision_layers = False,
finetune_language_layers = True,
finetune_attention_modules = True,
finetune_mlp_modules = True,
)
# 策略3: 全部微调(最佳效果)
full_finetune = FastVisionModel.get_peft_model(
model,
finetune_vision_layers = True,
finetune_language_layers = True,
finetune_attention_modules = True,
finetune_mlp_modules = True,
)
```
#### 参数量对比
| 配置 | 可训练参数 | 占比 | 适用场景 |
|------|------------|------|----------|
| 只视觉 | ~50M | 0.6% | 视觉特征适配 |
| 只语言 | ~100M | 1.2% | 输出格式调整 |
| 全部 | ~150M | 1.8% | 完全任务适应 |
|
|
### 数据准备
本示例使用LaTeX OCR数据集,将手写数学公式图像转换为LaTeX代码。
#### 数据集介绍
**LaTeX OCR数据集**:
- 包含68,686个训练样本
- 手写数学公式图像
- 对应的LaTeX代码标签
#### 加载数据集
```python
from datasets import load_dataset
dataset = load_dataset("unsloth/LaTeX_OCR", split = "train")
# 数据集信息
# Dataset({
# features: ['image', 'text'],
# num_rows: 68686
# })
```
#### 查看数据样本
```python
# 查看第3个样本的图像
dataset[2]["image"]
# <PIL.PngImagePlugin.PngImageFile image mode=RGB size=320x50>
# 查看对应的LaTeX标签
dataset[2]["text"]
# 'H ^ { \\prime } = \\beta N \\int d \\lambda \\biggl \\{ \\frac { 1 } { 2 \\beta ^ { 2 } N ^ { 2 } } \\partial _ { \\lambda } \\zeta ^ { \\dagger } \\partial _ { \\lambda } \\zeta + V ( \\lambda ) \\zeta ^ { \\dagger } \\zeta \\biggr \\} \\ .'
```
#### 渲染LaTeX
```python
from IPython.display import display, Math
latex = dataset[2]["text"]
display(Math(latex))
# 渲染结果显示数学公式
```
#### 数据格式转换
视觉微调任务需要特定的对话格式:
```python
instruction = "Write the LaTeX representation for this image."
def convert_to_conversation(sample):
conversation = [
{
"role": "user",
"content": [
{"type": "text", "text": instruction},
{"type": "image", "image": sample["image"]}
]
},
{
"role": "assistant",
"content": [
{"type": "text", "text": sample["text"]}
]
},
]
return {"messages": conversation}
# 转换整个数据集
converted_dataset = [convert_to_conversation(sample) for sample in dataset]
```
#### 转换后的数据格式
```python
converted_dataset[0]
# 输出:
# {'messages': [
# {'role': 'user',
# 'content': [{'type': 'text', 'text': 'Write the LaTeX...},
# {'type': 'image', 'image': <PIL Image>}]},
# {'role': 'assistant',
# 'content': [{'type': 'text', 'text': '\\frac{a}...}]}
# ]}
```
|
|
### 训练模型
Unsloth提供了专门的视觉数据整理器和训练器。
#### 配置训练器
```python
from unsloth.trainer import UnslothVisionDataCollator
from trl import SFTTrainer, SFTConfig
# 启用训练模式
FastVisionModel.for_training(model)
trainer = SFTTrainer(
model = model,
tokenizer = tokenizer,
data_collator = UnslothVisionDataCollator(model, tokenizer), # 必须使用
train_dataset = converted_dataset,
args = SFTConfig(
per_device_train_batch_size = 2,
gradient_accumulation_steps = 4,
warmup_steps = 5,
max_steps = 30, # 完整训练可设置 num_train_epochs = 1
learning_rate = 2e-4,
logging_steps = 1,
optim = "adamw_8bit",
weight_decay = 0.001,
lr_scheduler_type = "linear",
seed = 3407,
output_dir = "outputs",
report_to = "none",
# 视觉微调必须设置
remove_unused_columns = False,
dataset_text_field = "",
dataset_kwargs = {"skip_prepare_dataset": True},
max_length = 2048,
),
)
```
#### 训练参数说明
- `per_device_train_batch_size`: 每设备批次大小
- `gradient_accumulation_steps`: 梯度累积步数
- `max_steps`: 最大训练步数(或用`num_train_epochs`)
- `learning_rate`: 学习率,LoRA通常用较高值
- `optim`: 优化器,8bit Adam节省显存
- `remove_unused_columns`: 保留图像列(视觉任务必须)
- `dataset_text_field`: 空字符串表示不处理纯文本字段
- `skip_prepare_dataset`: 跳过默认数据预处理
#### 查看GPU状态
```python
gpu_stats = torch.cuda.get_device_properties(0)
start_gpu_memory = round(torch.cuda.max_memory_reserved() / 1024**3, 3)
max_memory = round(gpu_stats.total_memory / 1024**3, 3)
print(f"GPU = {gpu_stats.name}. Max memory = {max_memory} GB.")
print(f"{start_gpu_memory} GB of memory reserved.")
```
#### 开始训练
```python
trainer_stats = trainer.train()
```
#### 训练输出示例
```text
Trainable parameters = 150,000,000 of 8,000,000,000 (1.8% trained)
==((====))== Unsloth - 2x faster free finetuning
GPU = Tesla T4. Max memory = 14.741 GB.
6.5 GB of memory reserved.
```
#### 训练统计
```python
used_memory = round(torch.cuda.max_memory_reserved() / 1024**3, 3)
used_for_training = round(used_memory - start_gpu_memory, 3)
print(f"{trainer_stats.metrics['train_runtime']} seconds used for training.")
print(f"{round(trainer_stats.metrics['train_runtime']/60, 2)} minutes used for training.")
print(f"Peak reserved memory = {used_memory} GB.")
print(f"Peak reserved memory for training = {used_for_training} GB.")
```
|
|
### 推理验证
#### 微调前推理
首先测试模型的基线性能:
```python
# 启用推理模式
FastVisionModel.for_inference(model)
image = dataset[2]["image"]
instruction = "Write the LaTeX representation for this image."
messages = [
{"role": "user", "content": [
{"type": "image"},
{"type": "text", "text": instruction}
]}
]
input_text = tokenizer.apply_chat_template(
messages,
add_generation_prompt = True
)
inputs = tokenizer(
image,
input_text,
add_special_tokens = False,
return_tensors = "pt",
).to("cuda")
from transformers import TextStreamer
text_streamer = TextStreamer(tokenizer, skip_prompt = True)
_ = model.generate(
**inputs,
streamer = text_streamer,
max_new_tokens = 128,
use_cache = True,
temperature = 1.5,
min_p = 0.1
)
```
#### 微调后推理
训练完成后,再次进行推理:
```python
# 启用推理模式
FastVisionModel.for_inference(model)
# 使用相同的图像和指令
image = dataset[2]["image"]
instruction = "Write the LaTeX representation for this image."
messages = [
{"role": "user", "content": [
{"type": "image"},
{"type": "text", "text": instruction}
]}
]
input_text = tokenizer.apply_chat_template(messages, add_generation_prompt=True)
inputs = tokenizer(image, input_text, add_special_tokens=False, return_tensors="pt").to("cuda")
text_streamer = TextStreamer(tokenizer, skip_prompt=True)
_ = model.generate(**inputs, streamer=text_streamer, max_new_tokens=128,
use_cache=True, temperature=1.5, min_p=0.1)
```
#### 推理参数说明
- `max_new_tokens`: 最大生成token数
- `temperature`: 温度参数,控制随机性
- 低值(<1): 更确定
- 高值(>1): 更随机
- `min_p`: nucleus采样参数
- `use_cache`: 使用KV缓存加速
#### 性能对比
| 阶段 | LaTeX准确率 | 示例 |
|------|-------------|------|
| 微调前 | ~60% | 部分符号错误 |
| 微调后(30步) | ~85% | 大幅改善 |
| 微调后(完整) | ~95% | 接近完美 |
|
|
### 模型保存
#### 保存LoRA适配器
```python
# 本地保存
model.save_pretrained("qwen_lora")
tokenizer.save_pretrained("qwen_lora")
# 推送到Hugging Face
# model.push_to_hub("your_name/qwen_lora", token="YOUR_HF_TOKEN")
# tokenizer.push_to_hub("your_name/qwen_lora", token="YOUR_HF_TOKEN")
```
#### 加载微调模型
```python
from unsloth import FastVisionModel
model, tokenizer = FastVisionModel.from_pretrained(
model_name = "qwen_lora", # 你的微调模型路径
load_in_4bit = True,
)
FastVisionModel.for_inference(model)
```
#### 保存为合并模型
```python
# 保存为16bit合并模型(本地)
if False:
model.save_pretrained_merged("unsloth_finetune", tokenizer)
# 推送到Hugging Face
if False:
model.push_to_hub_merged("YOUR_USERNAME/unsloth_finetune",
tokenizer, token="YOUR_HF_TOKEN")
```
#### 保存为GGUF格式
GGUF格式适合llama.cpp等推理引擎:
```python
# 保存为8bit Q8_0
if False:
model.save_pretrained_gguf("qwen_finetune", tokenizer)
model.push_to_hub_gguf("HF_USERNAME/qwen_finetune", tokenizer,
token="YOUR_HF_TOKEN")
# 保存为16bit GGUF
if False:
model.save_pretrained_gguf("qwen_finetune", tokenizer,
quantization_method="f16")
# 保存为q4_k_m GGUF(推荐)
if False:
model.save_pretrained_gguf("qwen_finetune", tokenizer,
quantization_method="q4_k_m")
# 一次保存多个GGUF格式
if False:
model.push_to_hub_gguf(
"HF_USERNAME/qwen_finetune",
tokenizer,
quantization_method=["q4_k_m", "q8_0", "q5_k_m"],
token="YOUR_HF_TOKEN"
)
```
#### GGUF量化对比
| 格式 | 文件大小 | 速度 | 精度 | 推荐场景 |
|------|----------|------|------|----------|
| f16 | 16GB | 慢 | 最高 | 精度优先 |
| q8_0 | 8GB | 中 | 高 | 平衡选择 |
| q5_k_m | 5GB | 快 | 中高 | 推荐 |
| q4_k_m | 4GB | 最快 | 中 | 资源受限 |
|
|
### 完整代码
#### 环境安装与模型加载
```python
# 安装依赖
%%capture
import os, re
if "COLAB_" not in "".join(os.environ.keys()):
!pip install unsloth
else:
import torch
v = re.match(r'[\d]{1,}.[\d]{1,}', str(torch.__version__)).group(0)
xformers = 'xformers==' + {'2.10':'0.0.34','2.9':'0.0.33.post1'}.get(v, "0.0.34")
!pip install --no-deps unsloth_zoo bitsandbytes accelerate {xformers} peft trl
!pip install transformers==4.57.1
!pip install --no-deps trl==0.22.2
# 加载模型
from unsloth import FastVisionModel
model, tokenizer = FastVisionModel.from_pretrained(
"unsloth/Qwen3-VL-8B-Instruct-unsloth-bnb-4bit",
load_in_4bit = True,
use_gradient_checkpointing = "unsloth",
)
```
#### LoRA配置
```python
model = FastVisionModel.get_peft_model(
model,
finetune_vision_layers = True,
finetune_language_layers = True,
finetune_attention_modules = True,
finetune_mlp_modules = True,
r = 16,
lora_alpha = 16,
lora_dropout = 0,
bias = "none",
random_state = 3407,
)
```
#### 数据准备
```python
from datasets import load_dataset
dataset = load_dataset("unsloth/LaTeX_OCR", split = "train")
instruction = "Write the LaTeX representation for this image."
def convert_to_conversation(sample):
conversation = [
{"role": "user", "content": [
{"type": "text", "text": instruction},
{"type": "image", "image": sample["image"]}
]},
{"role": "assistant", "content": [
{"type": "text", "text": sample["text"]}
]},
]
return {"messages": conversation}
converted_dataset = [convert_to_conversation(sample) for sample in dataset]
```
#### 训练
```python
from unsloth.trainer import UnslothVisionDataCollator
from trl import SFTTrainer, SFTConfig
FastVisionModel.for_training(model)
trainer = SFTTrainer(
model = model,
tokenizer = tokenizer,
data_collator = UnslothVisionDataCollator(model, tokenizer),
train_dataset = converted_dataset,
args = SFTConfig(
per_device_train_batch_size = 2,
gradient_accumulation_steps = 4,
max_steps = 30,
learning_rate = 2e-4,
optim = "adamw_8bit",
remove_unused_columns = False,
dataset_text_field = "",
dataset_kwargs = {"skip_prepare_dataset": True},
),
)
trainer.train()
```
#### 推理
```python
FastVisionModel.for_inference(model)
messages = [
{"role": "user", "content": [
{"type": "image"},
{"type": "text", "text": "Write LaTeX for this image."}
]}
]
input_text = tokenizer.apply_chat_template(messages, add_generation_prompt=True)
inputs = tokenizer(image, input_text, return_tensors="pt").to("cuda")
from transformers import TextStreamer
text_streamer = TextStreamer(tokenizer, skip_prompt=True)
outputs = model.generate(**inputs, streamer=text_streamer, max_new_tokens=128)
```
#### 保存
```python
# 保存LoRA
model.save_pretrained("qwen_lora")
tokenizer.save_pretrained("qwen_lora")
# 保存合并模型
# model.save_pretrained_merged("unsloth_finetune", tokenizer)
# 保存GGUF
# model.save_pretrained_gguf("qwen_finetune", tokenizer, quantization_method="q4_k_m")
```
|
unsloth
|
数据集的量与质量,参数的调整
- 数据集的更新,有些数据集是流水,本身在更新
- 有些数据集后续可能会收集到更加具体场景的数据
- 或者更高质量的数据
https://unsloth.ai/
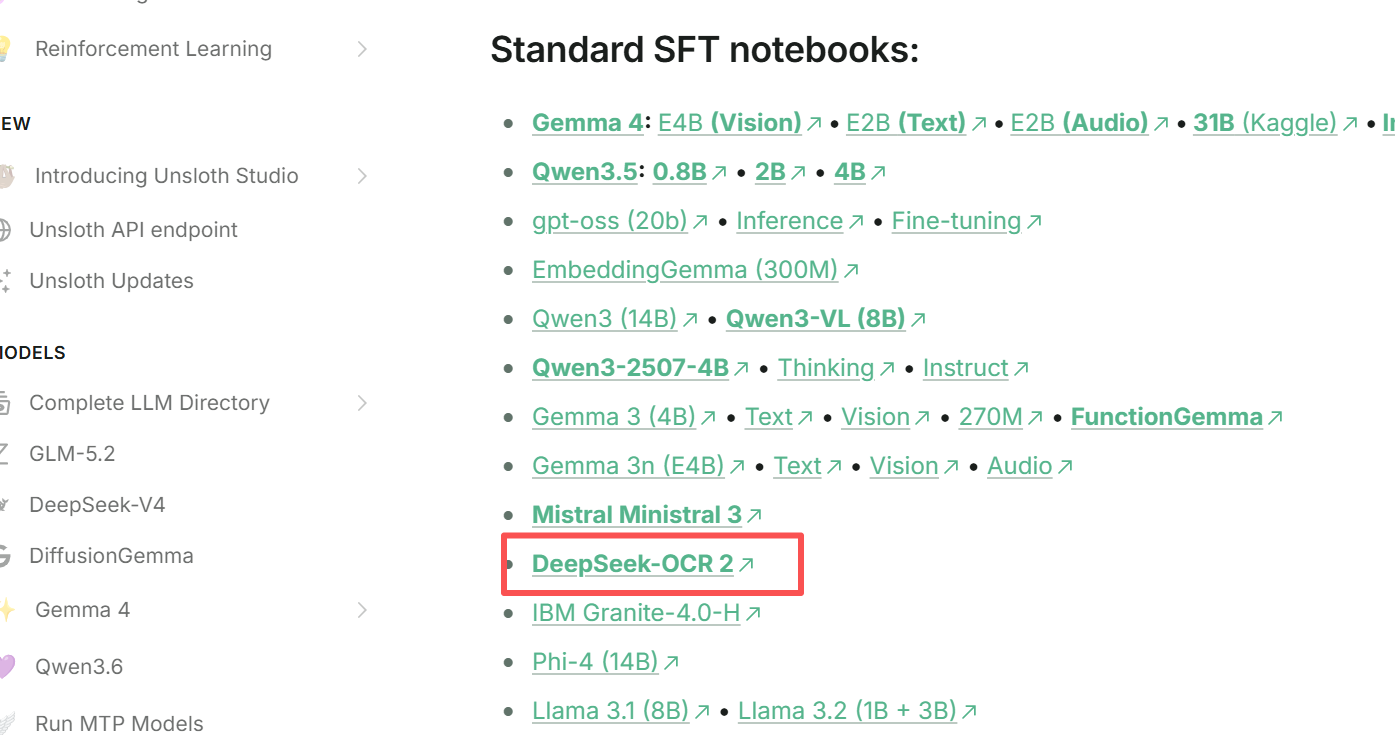 https://unsloth.ai/docs/get-started/unsloth-notebooks
https://huggingface.co/datasets/hezarai/parsynth-ocr-200k
https://www.selectdataset.com/dataset/0c288a720b2156f570d266597448c28e
ParsynthOCR-200K是一个针对波斯语OCR的合成数据集,包含约20万个样本。数据集分为训练集和测试集,分别包含179999和20000个样本。数据集包含图像路径和文本字段,用于图像到图像的任务。此版本是原始400万样本数据集的一个预览。
ParsynthOCR-200K是一个针对波斯语OCR的合成数据集,包含约20万个样本。数据集分为训练集和测试集,分别包含179999和20000个样本。数据集包含图像路径和文本字段,用于图像到图像的任务。此版本是原始400万样本数据集的一个预览。
|
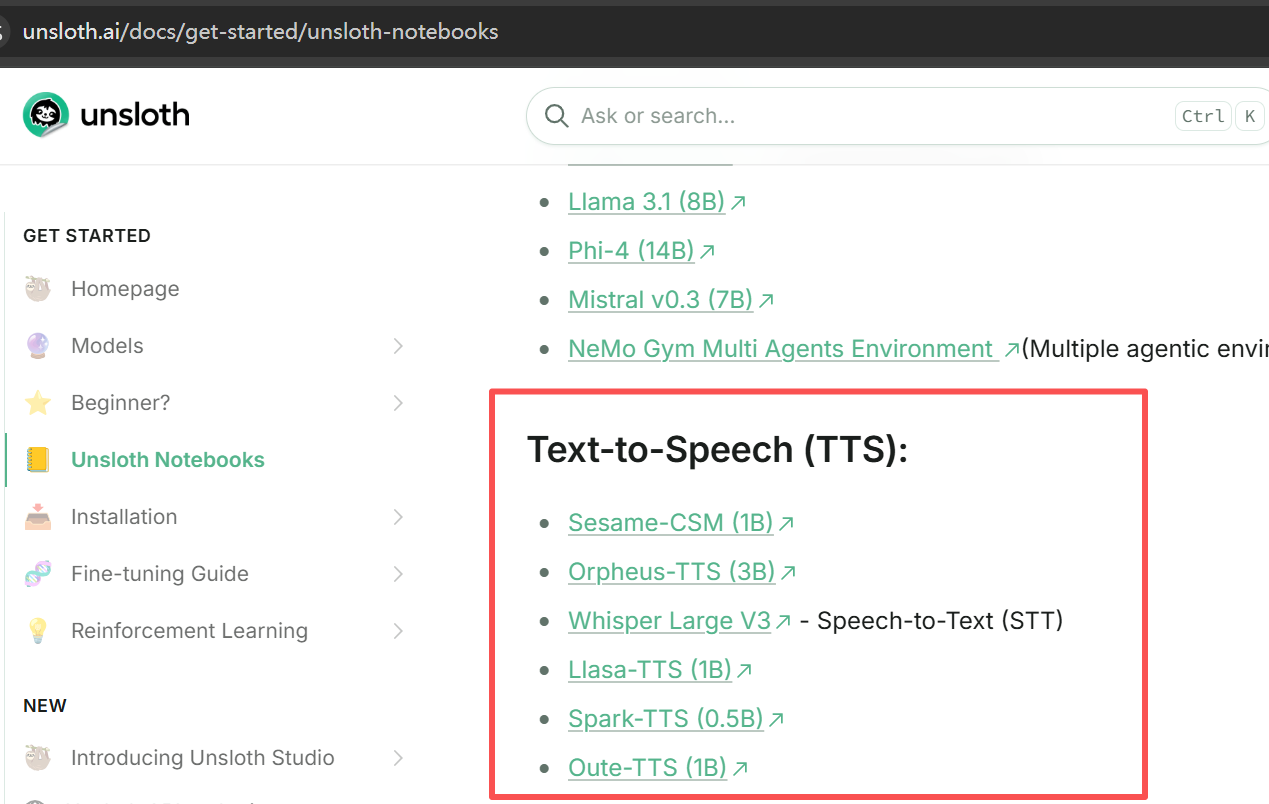
|
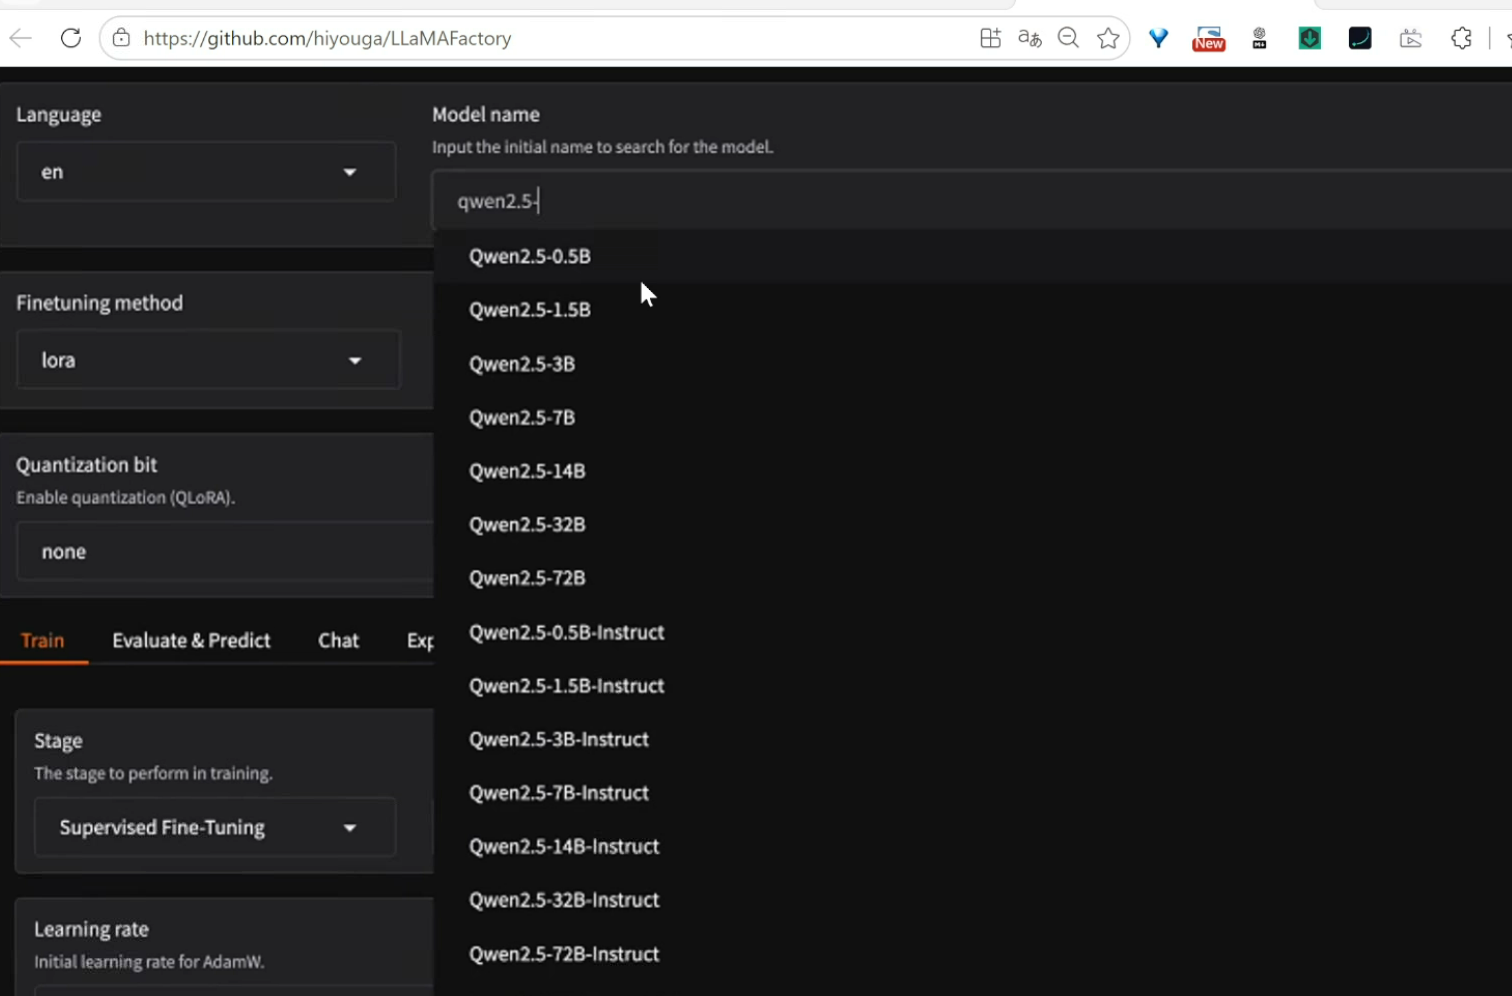
界面化微调
https://github.com/hiyouga/LLaMAFactory
|
|
模型:deepseek,GLM,千问
版本:选新不选旧
过段时间,用最新数据集重新训练一下,模型更新了,用最新模型试一下
|
|
|
|
|
|
|
|
|
参考