激活函数
经实践验证,激活函数有增加模型表达能力的作用;
如果没有激活函数,模型就全是线性运算,
而激活函数,是非线性运算,两者组合后,经实验证明,有了更强的表达能力

模型有更强的表达能力是什么意思?
线性回归公式理论上可以近似一切事物,

对于不同事物,完成这个过程花费的时间不一样,精度上限也不同;
增加一些非线性变换,模型可以更快地达到近似的上限,
同时,还能将这个上限提高一些,比如
线性变换花3天算出10天后会下雨,
增加非线性变换后,1小时就算出了10天后会下雨
线性变换在模型是一层,模型有层数再多,依然是线性变换,是线性的
随着空间维度的提升,它依然是线性,只是呈现的形态不同,线性,平面,超平面...

但现实事物之间的关系不是线性的
增加一些非线性关系,可以提升模型的表达能力
当然也不是任意的非线性关系都行,
- 要考虑到计算机能算的动,越简单越好
- 要考虑到在数学上求导能成立,必须要靠梯度下降大法求极小值
- 要考虑工程上实现成本低,代价低,成本太高就不赚钱了
- 效果要有提升,模型的表达能力要变得更强...

综合以上因素,学者不断尝试,总结出了一些激活函数
|
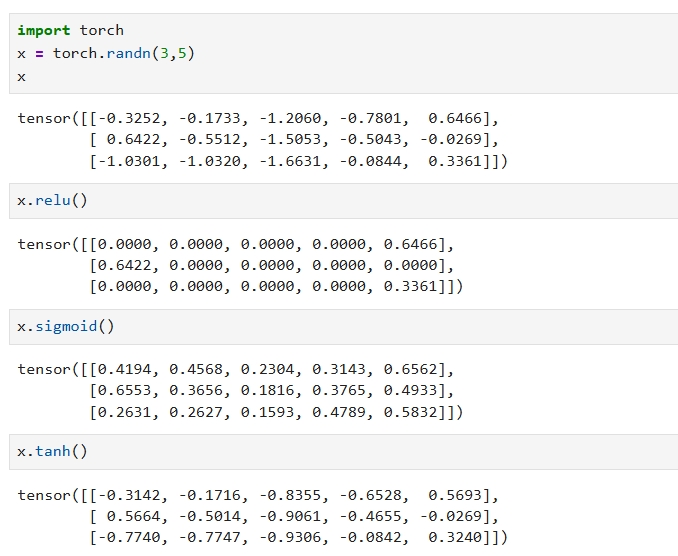
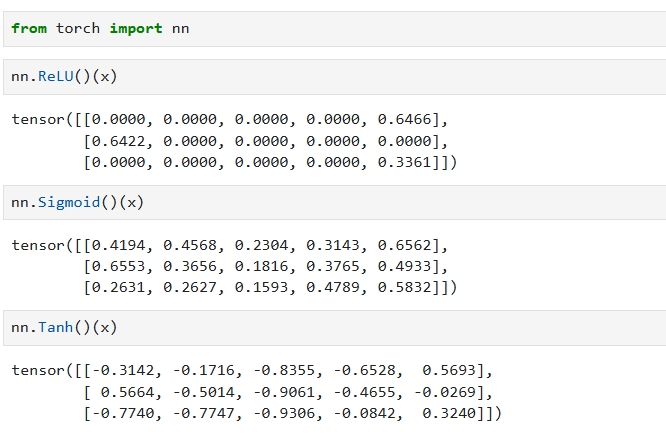
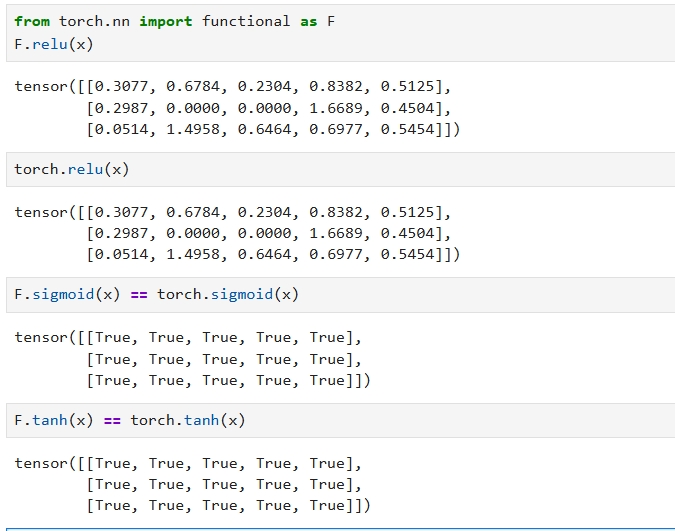
|
|
激活函数的位置 矩阵相乘是线性变换, 两个相连的线性变换,可简化为一个线性变换,一步到位 y=ax+b,z=cy+d,由x两步到z与一步到z,没有质的改变 所以,一个线性变换后面就跟一个激活函数,增加一些非线性的能力 不也是说,纯粹的线性变换不能解决问题, 比如transformer的每一层中,有以下几步: 1 求补码, 2 编码并按特征维度拆分, 3 矩阵相乘,即线性变换 4 做softmax, 5 求得分, 6 再矩阵相乘,即线性变换 7 层归一化 8 全连接, 9 激活函数处理, 10 全连接 1-7 是一个逻辑,这一通计算后数据分布肯定偏移了,第8步加一个归一化 线性变换与激活函数都是神经网络中的一个技巧,还可以有其他处理技巧 激活函数在每层中出现一次,且位于最后一个全连接的前面,或者是两个线性变换之间, 因为它的目的是为变换增加一些非线性能力 最好激活函数前面也是一个全连接,相当了,BN有自动学习参数,放ReLU也无大的问题 |
线性变换与逻辑回归就差一个激活函数
- 表达能力相差了很多

原来的线性变换,尤其是纯线性变换相互嵌套还是在线性表达的范畴,其能力总是上不去
- 于是就尝试了各种办法,其中有效的就是在神经网络中加入非线性函数
- 加入后神经网络的能力大大增加,就像一个网络被激活了一样
在非线性函数中,也有很多尝试,同时满足以下三点的函数 - 简单 - 工程有效 - 方便求导 活下来了 在活下来的函数中,最让人不可思议的是relu - 因为它直接舍弃了小于0的数, - 从人的逻辑来看,这绝对是不可能的 - 但从计算机,从工程的角度来看,它是有效的,并且效果不错... 因此,人们意识到,有些算法是反人类思维的! |
现实函数何其多,比如
y = x*x
y = sin(x)

但最开始的神经网络是线性变换,线性与线性的组合,真的可以模仿这些“弯曲”的函数吗?

线是直线,多维是超平面,任何一个都做不到,在数学上做不到
相像一下,如果用一小段线段 拟合函数的一小部分,然后再让直线弯曲一下,就再能拟合一小部分 - 如此,不管原函数多复杂,只要线段够短,只要能“弯曲”一下,那么就能拟合 “弯曲”这个理论由激活函数实现,或者说激活函数之所以能增强线性变换模型的表达能力 - 就在于激活函数,可以让线性“弯曲”一下 足够短,足够多,是由神经网络的层数实现的 - 实际上是短接思想,主数据不变,每次加上一点点由导数带来的微小变化 - 实现框架有transformer 实践证明,transformer 可以拟合任何函数,不管你是什么函数 - 只要给出足够多的数据,就能以极高的概率拟合成功 这已经不是强大,而是神奇,是伟大了! |
定义域 为 [负无穷,正无穷]

         值域     导数
relu     0或1     导数为0,1, 0,1 生万数,万数之源 ,最常用
sigmoid  [0,1]    值域巧 在与概率的范围重叠,有导数消失问题,仅次于relu
tanh     [-1,1]   值域以0为中心,有导数消失问题,不常用
|
|
relu
import torch
torch.manual_seed(73)
x = torch.randn(3,7)
x
tensor([[ 0.3408,  0.2297,  1.7066,  1.3925, -0.2963,  0.2836, -0.5602],
        [ 1.4158,  1.6667, -0.2644, -1.1022, -0.8187, -0.3501, -0.0052],
        [-1.6498,  0.9515,  0.7178, -2.0773,  1.6672,  0.5206,  1.6483]])
x.relu()
tensor([[0.3408, 0.2297, 1.7066, 1.3925, 0.0000, 0.2836, 0.0000],
        [1.4158, 1.6667, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.0000, 0.9515, 0.7178, 0.0000, 1.6672, 0.5206, 1.6483]])
torch.relu(x)
tensor([[0.3408, 0.2297, 1.7066, 1.3925, 0.0000, 0.2836, 0.0000],
        [1.4158, 1.6667, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.0000, 0.9515, 0.7178, 0.0000, 1.6672, 0.5206, 1.6483]])
from torch import nn
relu = nn.ReLU()
relu(x)

tensor([[0.3408, 0.2297, 1.7066, 1.3925, 0.0000, 0.2836, 0.0000],
        [1.4158, 1.6667, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.0000, 0.9515, 0.7178, 0.0000, 1.6672, 0.5206, 1.6483]])
from torch.nn import functional as F
F.relu(x)

tensor([[0.3408, 0.2297, 1.7066, 1.3925, 0.0000, 0.2836, 0.0000],
        [1.4158, 1.6667, 0.0000, 0.0000, 0.0000, 0.0000, 0.0000],
        [0.0000, 0.9515, 0.7178, 0.0000, 1.6672, 0.5206, 1.6483]])
|
|
np.array([0 if ele < 0 else ele for ele in x]) 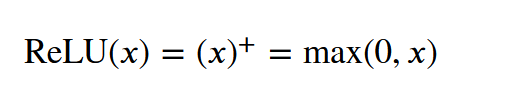
import numpy as np
import torch
from torch import nn
from torch.nn import functional as F

class Activate(object):

    def __init__(self):
        pass

    @staticmethod
    def relu(X):
        X = np.array(X)
        shape = X.shape
        X = X.reshape(-1)
        x = np.array([0 if x < 0 else x for x in X])
        x = x.reshape(shape)
        return x

    @staticmethod
    def relu2(X):
        X = torch.tensor(data=X,dtype=torch.float64)
        return X.relu()

    @staticmethod
    def relu3(X):
        X = torch.tensor(data=X)
        return F.relu(input=X,inplace=True)


np.random.seed(73)
A=np.random.randn(7,3)
# print(A)
"""
[[ 0.57681305  2.1311088   2.44021967]
    [ 0.26332687 -1.49612065 -0.03673531]
    [ 0.43069579 -1.52947433 -0.73025968]
    [ 1.05131524  1.61979267 -1.60501337]
    [ 0.33100953 -0.21095236  0.2981767 ]
    [-1.14607352  0.57536202 -0.36390663]
    [ 0.03639919 -0.52056399 -0.01576433]]
"""

# B = Activate.relu(X=A)
# print(B)
"""
[[0.57681305 2.1311088  2.44021967]
    [0.26332687 0.         0.        ]
    [0.43069579 0.         0.        ]
    [1.05131524 1.61979267 0.        ]
    [0.33100953 0.         0.2981767 ]
    [0.         0.57536202 0.        ]
    [0.03639919 0.         0.        ]]
"""

# B = Activate.relu2(X=A)
# print(B)
"""可以看出torch.relu()只保留了四位有效数字
tensor([[0.5768, 2.1311, 2.4402],
        [0.2633, 0.0000, 0.0000],
        [0.4307, 0.0000, 0.0000],
        [1.0513, 1.6198, 0.0000],
        [0.3310, 0.0000, 0.2982],
        [0.0000, 0.5754, 0.0000],
        [0.0364, 0.0000, 0.0000]], dtype=torch.float64)
"""

B = Activate.relu3(X=A)
print(B)
"""F.relu同样改变了数据的精度
tensor([[0.5768, 2.1311, 2.4402],
        [0.2633, 0.0000, 0.0000],
        [0.4307, 0.0000, 0.0000],
        [1.0513, 1.6198, 0.0000],
        [0.3310, 0.0000, 0.2982],
        [0.0000, 0.5754, 0.0000],
        [0.0364, 0.0000, 0.0000]], dtype=torch.float64)
"""
|
以0为分界点,
- 低于0的数据为0,直接就不用算了,因为任何数乘以0就是0
- 高于0,则导数为1,链式求导中,激活函数不会放大或缩小导函数中的值了,导函数值的大小只受参数变量的影响
- 0与1是极其特殊的两个数字,在这个简单的不能再简单的函数中,同时出现了,也有点神乎其技的感觉...

计算量低,效果也并不比sigmoid差,极受工程青睐
- 主要是当参数成千上万时,会有亿万个激活函数在运行
- 这就要求函数越简单越好
缺点是当x小于0时,直接置为0,在理论上好像不太好 |
|
|
|
|
|
|
nn.PReLU
nn.PReLU(num_parameters=10, init=0.25)
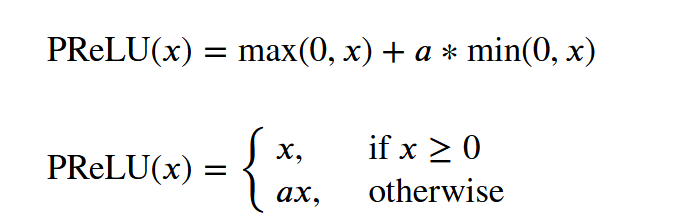
nn.PReLU(): a 可学习,根据数据变化而变化
PReLU(𝑥)=max(0,𝑥)+𝑎∗min(0,𝑥)

其中a是可学习的参数/权重,
当x大于等于0时,取x,
当x小于0时,是完全舍去还是按比例保留,通过学习而定

超参数:
num_parameters (int):输入数据的通道数
init (float):超参数a的初始化值,默认0.25

示例:
self.layer = nn.Sequential(
    nn.Conv2d(in_channels=3,
                out_channels=10,
                kernel_size=3,
                stride=1,
                padding=1),
    nn.BatchNorm2d(num_features=10),
    nn.PReLU(num_parameters=10, init=0.25),
    nn.MaxPool2d(kernel_size=2, stride=2)
)
Rrule
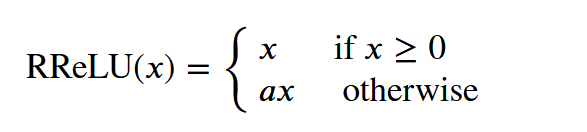
nn.RReLU()
RReLU中的 a是一个在 一个给定的范围内 随机抽取的值。
sigmoid
import numpy as np
from matplotlib import pyplot as plt

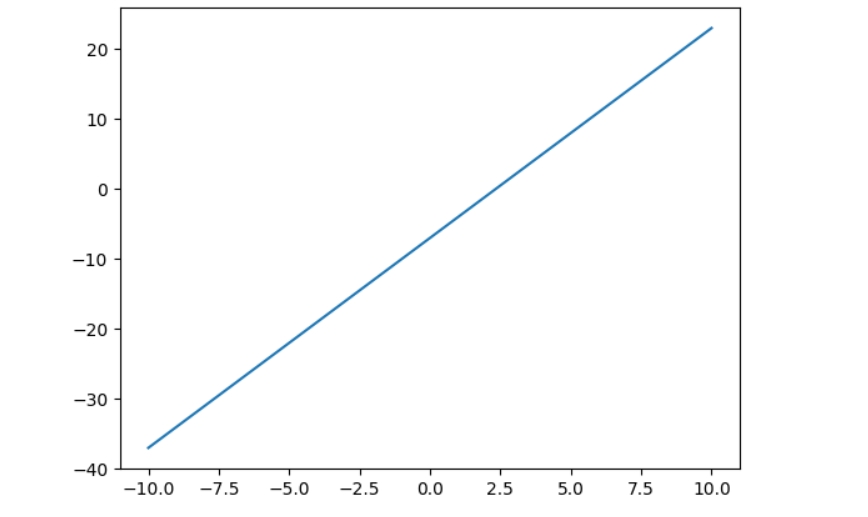
def linear(x):
    return 3 * x - 7

x = np.linspace(start=-10, stop=10, num=50)

plt.plot(x, linear(x))
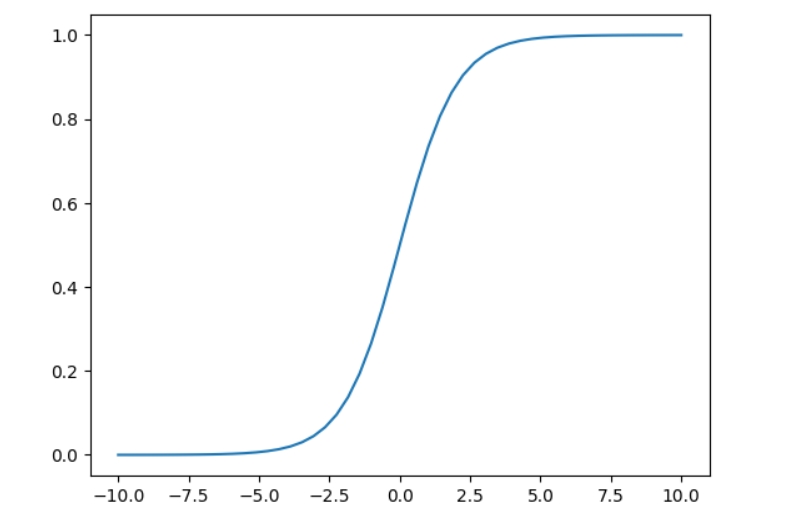
def sigmoid(x):
    return 1 / (1 + np.exp(-x))

plt.plot(x, sigmoid(x))
|
sigmoid函数将数据映射到[0,1]
- 对应概率,可以将数据转换为概率
- 也有类似计算机非0即1的意味
- e函数求导方便
- 对定义域无限制,可以是任何实数,即不管数据范围如何,都到映射到[0,1]
缺点
- 指数函数在计算机中比线性函数计算量大
- 对于分布来说,以0为中心更好一些
- 当数据比较大时,sigmoid函数的梯度会变得很小
  - 深度学习中求导是链式示求导,
  - 即损失函数在某个参数变量处的导数值是n个导函数的值相乘
  - 本身就很小,再相乘,就更小了
  - 最后梯度就消失了,w=w-lr*w.grad梯度下降变为梯度不变
  - 如此参数就无法更新了,模型就训练不下去了
|
|
|
|
|
|
|
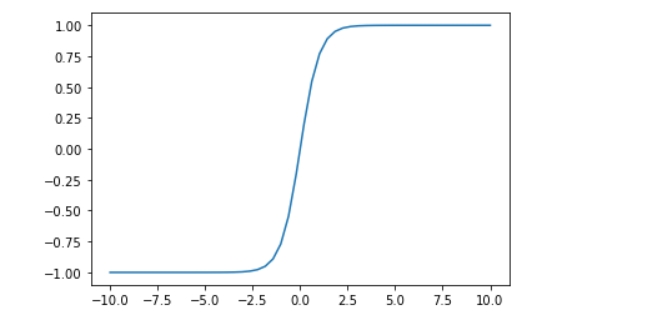
tanh
def tanh(x):
    return (np.exp(x) - np.exp(-x)) / (np.exp(x) + np.exp(-x))
|
双曲正切函数,相比sigmoid函数
- 数据以0为中心,[-1,1]

缺陷
- 同sigmoid一样,但它又不像sigmoid函数那样可以类比概率
- 所以应用的场景很少,基本不用了
|
|
|
|
|
|
|
nn.LeakyReLU
|
### 方法作用
`nn.LeakyReLU` 是 **ReLU(Rectified Linear Unit)激活函数** 的改进版本。
#### ReLU 的问题
普通 ReLU 在输入为负数时输出恒为 0:
```
f(x) = max(0, x)
```
这会导致一些神经元在训练过程中永远不被激活,梯度始终为 0,无法更新权重,称为 **"神经元死亡"(Dying ReLU)** 问题。
#### LeakyReLU 的改进
LeakyReLU 在负区间引入一个小的斜率,让负数也能保留一点梯度:
```
f(x) = x, x >= 0
f(x) = negative_slope * x, x < 0
```
例如 `negative_slope=0.1` 时:
- 正数:`f(5) = 5`
- 负数:`f(-5) = 0.1 * (-5) = -0.5`
这样既保留了 ReLU 计算简单、收敛快的优点,又缓解了神经元死亡问题。
#### 在 YOLOv3 中的应用
在 `/ai/wks/aitpf/src/tpf/case/cv/yolov3.ipynb` 中,每个卷积块都使用 `Conv + BatchNorm + LeakyReLU` 的组合:
```python
self.act = nn.LeakyReLU(0.1, inplace=True)
```
这是 YOLO 系列网络的经典配置,`0.1` 的负斜率在检测任务中表现稳定。
|
|
### 参数说明
| 参数 | 类型 | 默认值 | 说明 |
|------|------|--------|------|
| `negative_slope` | float | `1e-2`(即 0.01) | 负值区域的斜率。控制负数经过激活函数后的衰减程度 |
| `inplace` | bool | `False` | 是否原地修改输入张量。`True` 可节省内存,但会覆盖原始数据 |
#### `negative_slope` 详解
- `negative_slope=0`:退化为普通 ReLU,负数全部输出 0
- `negative_slope=0.01`:标准 LeakyReLU,负数保留 1% 的梯度
- `negative_slope=0.1`:YOLOv3 中使用的配置,负数保留 10% 的梯度
- `negative_slope` 越大,负数信息保留越多,但可能引入更多负值噪声
#### `inplace` 详解
- `inplace=False`(默认):创建新的输出张量,原输入不变,安全但多占内存
- `inplace=True`:直接修改输入张量,节省内存,但不能再访问激活前的值
**注意**:在需要保留中间结果用于反向传播或可视化时,建议使用默认的 `inplace=False`。
|
|
### 使用示例
#### 示例 1:基本用法
```python
import torch
import torch.nn as nn
# 创建 LeakyReLU 激活函数,负斜率为 0.1
m = nn.LeakyReLU(0.1)
input = torch.tensor([-2.0, -1.0, 0.0, 1.0, 2.0])
output = m(input)
print(output)
# tensor([-0.2000, -0.1000, 0.0000, 1.0000, 2.0000])
```
计算过程:
- `-2.0 * 0.1 = -0.2`
- `-1.0 * 0.1 = -0.1`
- `0.0` 保持为 `0.0`
- 正数保持不变
#### 示例 2:YOLOv3 中的 ConvBNLeaky
```python
import torch
import torch.nn as nn
class ConvBNLeaky(nn.Module):
"""Conv + BatchNorm + LeakyReLU"""
def __init__(self, in_channels, out_channels, kernel_size, stride=1):
super().__init__()
padding = (kernel_size - 1) // 2
self.conv = nn.Conv2d(in_channels, out_channels, kernel_size,
stride, padding, bias=False)
self.bn = nn.BatchNorm2d(out_channels)
self.act = nn.LeakyReLU(0.1, inplace=True)
def forward(self, x):
return self.act(self.bn(self.conv(x)))
# 测试
x = torch.randn(2, 32, 13, 13)
layer = ConvBNLeaky(32, 64, kernel_size=3)
out = layer(x)
print(out.shape) # torch.Size([2, 64, 13, 13])
```
#### 示例 3:与普通 ReLU 对比
```python
import torch.nn as nn
x = torch.tensor([-3.0, -1.0, 0.0, 1.0, 3.0])
relu = nn.ReLU()
leaky_relu = nn.LeakyReLU(0.1)
print("ReLU: ", relu(x))
# tensor([0., 0., 0., 1., 3.])
print("LeakyReLU: ", leaky_relu(x))
# tensor([-0.3000, -0.1000, 0.0000, 1.0000, 3.0000])
```
|
参考
神经网络】神经元ReLU、Leaky ReLU、PReLU和RReLU的比较